


🎨 Seedream 5.0 Pro — het vlaggenschip onder de beeldmodellen van ByteDance: tot 2K, ongeëvenaarde typografie & bewerken met meerdere referenties!


daVinci MagiHuman - generator van tekst/afbeelding naar video met audiosynchronisatie
Maak video's met daVinci MagiHuman - een open source audio-videobasismodel van 15B van Sand.ai en SII GAIR Lab. Genereer gesynchroniseerde video en audio op basis van tekst of afbeeldingen met toonaangevende lipsyncnauwkeurigheid in 7 talen. Ondersteunt resolutie tot 1080p met een duur van 5-10 seconden. Aangedreven door een single-stream Transformer-architectuur zonder cross-attention, die op één H100 een video van 5 seconden in 256p in slechts 2 seconden levert.
Galerij daVinci MagiHuman tekst naar video
Ervaar de cinematische kracht van daVinci MagiHuman bij het genereren van tekst naar video. Maak indrukwekkende video's met gesynchroniseerde audio op basis van gedetailleerde tekstbeschrijvingen, met toonaangevende lipsync in 7 talen.
Regenachtige nacht in Tokio
Een vrouw in een rode jas loopt op een regenachtige avond door een neonverlicht steegje in Tokio, met glinsterende weerspiegelingen.
“Rainy night in a neon-lit Tokyo alley, a woman in a red coat walks slowly under an umbrella. Reflections shimmer on wet cobblestones. Handheld camera follows her from behind, bokeh street lights, cinematic color grade, moody atmosphere.”

Galerij daVinci MagiHuman afbeelding naar video
Zet je statische afbeeldingen om in dynamische video's met daVinci MagiHuman. Ervaar naadloze conversie van afbeelding naar video met realistische gezichtsuitdrukkingen, natuurlijke lichaamsbeweging en gesynchroniseerde audio met lipsync.
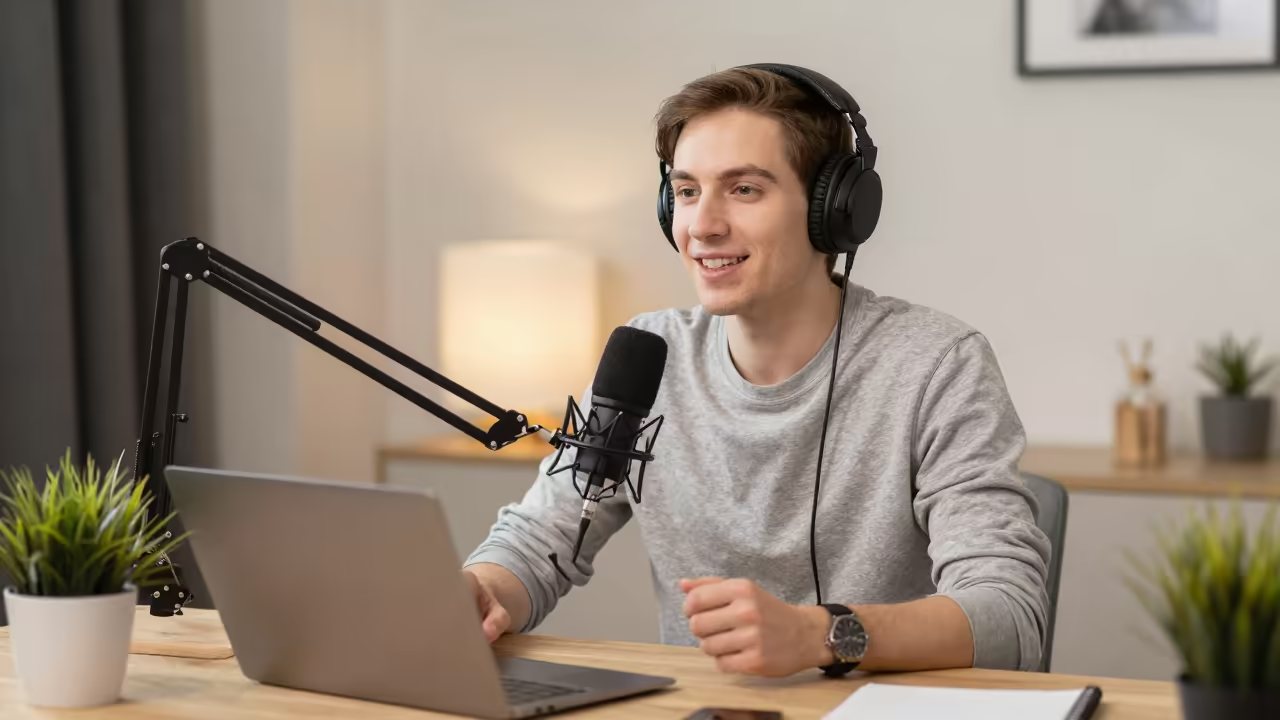
Podcastpresentator aan het woord
Wat is daVinci MagiHuman
Het open-source audio-videofoundationmodel van Sand.ai met 15B parameters en de beste lipsync in zijn klasse
- 15BParameters
- 1080pMax. resolutie
- 7Ondersteunde talen
- 2sGeneratiesnelheid op 256p
daVinci MagiHuman is een single-stream Transformer met 15 miljard parameters die video en audio synchroon genereert op basis van tekst of afbeeldingen en een toonaangevende lipsync-nauwkeurigheid haalt met een woordfoutpercentage van 14.6% in 7 talen.
De krachtige functies van daVinci MagiHuman
Ontdek de geavanceerde mogelijkheden die daVinci MagiHuman uitzonderlijk maken voor het genereren van audio en video
- 01
Audio en video in één keer genereren
Genereer gesynchroniseerde video en audio in één doorloop met een uniforme single-stream Transformer-architectuur die alleen self-attention gebruikt, zodat aparte audiopijplijnen overbodig zijn.
- 02
Toonaangevende lipsync
Haal een woordfoutpercentage van 14.6% bij lipsynchronisatie en presteer daarmee duidelijk beter dan concurrenten als Ovi 1.1 (40.45%) en LTX 2.3 (19.23%) in benchmarks voor spraaknauwkeurigheid.
- 03
Spraak in 7 talen
Genereer video’s met gesynchroniseerde spraak in het Engels, Chinees (Mandarijn en Kantonees), Japans, Koreaans, Duits en Frans, met natuurlijke uitspraak en lipbewegingen.
- 04
Razendsnel genereren
Maak een video van 5 seconden op 256p in slechts 2 seconden op één H100-GPU. Dankzij 8-staps DMD-2-distillatie is classifier-free guidance niet meer nodig, zonder verlies van kwaliteit.
- 05
Twee invoermodi
Maak video’s vanuit tekstprompts of animeer stilstaande beelden. Zowel tekst naar video als afbeelding naar video ondersteunt instelbare beeldverhoudingen, resoluties en een duur van 5 tot 10 seconden.
- 06
Superresolutie tot 1080p
Genereer video’s op 256p, 540p, 720p of 1080p via een superresolutiepijplijn in de latente ruimte die opschaalt zonder extra VAE-decode-encode-overhead, voor efficiënte uitvoer in hoge resolutie.
- 07
Open source onder Apache 2.0
Volledig open source onder de Apache 2.0-licentie, met de complete stack: basisgewichten, gedistilleerd model, superresolutiemodel en inferentiecode, voor onbeperkt commercieel gebruik.
- 08
Uitmuntend in mensgerichte video
Gespecialiseerd in digitale mensen met expressief gezichtsspel, realistische lichaamsbeweging en een personage dat door alle frames heen consistent blijft, voor professionele talking-headcontent.

Zo gebruik je daVinci MagiHuman tekst naar video
Genereer video's met gesynchroniseerd geluid op basis van tekstbeschrijvingen
- 01
Schrijf je prompt
Voer een gedetailleerde beschrijving in van de video die je wilt maken. Vermeld het onderwerp, de actie, wat er gezegd wordt en in welke taal, voor de beste lipsynchrone resultaten.
- 02
Instellingen configureren
Kies de resolutie (256p tot 1080p), de beeldverhouding (16:9 of 9:16) en de duur (5-10 seconden). Kies de spreektaal uit 7 ondersteunde talen.
- 03
Video genereren
Klik op genereren en daVinci MagiHuman maakt je video met gesynchroniseerd geluid en lipsynchrone spraak in één generatieronde.
Zo gebruik je daVinci MagiHuman afbeelding naar video
Animeer stilstaande afbeeldingen tot video's met gesynchroniseerd geluid
- 01
Upload je afbeelding
Upload een referentieafbeelding van de persoon of scène die je wilt animeren. daVinci MagiHuman blinkt uit in content met mensen, met realistische gezichtsuitdrukkingen en lichaamsbewegingen.
- 02
Voeg een prompt en instellingen toe
Beschrijf de gewenste beweging en spraak. Kies de resolutie (256p tot 1080p), de beeldverhouding, de duur (5-10 seconden) en de spreektaal uit 7 ondersteunde talen.
- 03
Genereer de geanimeerde video
Klik op genereren om je afbeelding om te zetten in een dynamische video met natuurlijke beweging, expressief spel en lipsynchrone audio, alles in één generatie.
YouTube-video's over daVinci MagiHuman
Bekijk demonstraties en reviews uit de community die laten zien wat daVinci MagiHuman kan op het gebied van audio-videogeneratie
- daVinci-MagiHuman: Fast Audio-Video Synthesis - AI Research Roundup
- 达芬奇最新开源模型,革命Seedance2.0 DaVinci-MagiHuman:开源音视频生成新标杆,5秒视频2秒出,还能说6种语言! - XIAOXIAO LI
- LTX 2.3, Veo и Sora больше не нужны? Тестируем daVinci-MagiHuman - ServerFlow AI Lab - R&D в области ИИ и LLM
- Ai动画224-化繁为简!daVinci-MagiHuman,快速音视频生成基础模型的单流架构,支持多国语言,音画同步,音色参考-T8 Comfyui教程 - T8star-Aix
YouTube-video's over daVinci MagiHuman
Bekijk demonstraties en reviews uit de community die laten zien wat daVinci MagiHuman kan op het gebied van audio-videogeneratie
Populaire reviews over daVinci MagiHuman op X
Ontdek wat mensen zeggen over daVinci MagiHuman op X (Twitter)
Ontdek andere modellen
Meer top-AI-modellen die je hier direct kunt proberen.
 NEW
FLUX 3
Het multimodale videomodel van Black Forest Labs: tekst, beeld, begin- en eindframes en video verlengen met native audio, 5-20 seconden tot 1080p
HappyHorse 1.0
#1-videomodel van Alibaba, met cinematische output van hoge kwaliteit
 NIEUW
Wan 3.0
Geünificeerd WAN-model: tekst, beeld en referentie naar video, tot 30 seconden in één keer, met native audio
 NEW
Kling 4.0 Flash
Het 720p-Kling-model van Kuaishou: shots van 3–20 s met native audio, referenties en video bewerken
 NEW
Veo 3.1
Google Veo 3.1 maakt cinematische 1080p-video’s met native audio en lipsync
 NIEUW
Gemini Omni Flash
Het snelle multimodale model van Google voor korte video’s, met synchrone native audio en ondersteuning voor tekst naar video, afbeelding naar video, referentie naar video en videobewerking
AI-abonnementen en prijzen
Flexibele AI-prijzen
Credits die je per keer afrekent, of een abonnement. Geen verborgen kosten, altijd opzegbaar.
Eenmalig ondersteunt betalen met crypto (BTC, USDT, ETH, 350+) · Monthly billing
Free-Eenmalig
Try before you buy
- Up to 3 videos
- Up to 32 images
- Multi-Model Support
- Text to Video
- Image to Video
- Video to Video
Meer tonen (+11)
- Consistent Character
- AI Animation Generator
- Templates & Effects
- AI Video Enhancers
- Interactive Community
- Faster Generation Speed
- No-watermark Outputs
- More Camera Movement
- Private Video Visibility
- Copy Protection
- Priority Support
Pro-1 maand
PopulairElevate your AI experience
- Up to 80 videos
- Up to 800 images
- 3 tasks(Parallel Tasks)
- Multi-Model Support
- Text to Video
- Image to Video
Meer tonen (+12)
- Video to Video
- Consistent Character
- AI Animation Generator
- Templates & Effects
- AI Video Enhancers
- Interactive Community
- Faster Generation Speed
- No-watermark Outputs
- More Camera Movement
- Private Video Visibility
- Copy Protection
- Priority Support
Lite-1 maand
Start your AI journey
- Up to 30 videos
- Up to 300 images
- 3 tasks(Parallel Tasks)
- Multi-Model Support
- Text to Video
- Image to Video
Meer tonen (+12)
- Video to Video
- Consistent Character
- AI Animation Generator
- Templates & Effects
- AI Video Enhancers
- Interactive Community
- Faster Generation Speed
- No-watermark Outputs
- More Camera Movement
- Private Video Visibility
- Copy Protection
- Priority Support
- Card
- Crypto geaccepteerd (BTC, USDT, ETH, 350+)
Veelgestelde vragen
Veelgestelde vragen over audio- en videogeneratie met daVinci MagiHuman