


🎨 Seedream 5.5 — новейшая модель изображений ByteDance: нативный прозрачный фон, до 2K и редактирование по 10 референсам!


Генератор WAN 3.0: текст / изображение / референс в видео
Создавайте видео с WAN 3.0 — единой видеомоделью Alibaba Tongyi Lab — на Dreamega AI. Напишите запрос для текста-в-видео, оживите первый кадр с необязательным последним кадром для изображения-в-видео или объедините до 10 референсных изображений, 5 видео и 5 аудиодорожек. Каждый режим выдаёт от 2 до 30 секунд в 480p, 720p или 1080p с нативным синхронным звуком.
Серия моделей WAN
WAN 3.0 Prime
Более быстрая версия Wan 3.0 с редактированием и продлением
WAN 2.7
Последняя версия с генерацией текст-изображение, редактированием и видео
WAN 2.6
Улучшенная генерация видео с режимами референса и быстрым
WAN 2.5
Высококачественная генерация видео из текста и изображений
WAN 2.2
Генерация видео с множеством соотношений сторон
WAN 2.2 Animate
Специализированная анимация и генерация движения
WAN 2.1
Базовая модель с текстовым и графическим вводом
Галерея видео WAN 3.0
Смотрите ролики, созданные в WAN 3.0 по текстовым запросам. Каждый пример сгенерирован за один проход с нативным синхронным звуком.
Астронавт в заросшем городе
Астронавт проходит через отвоёванный природой город и встречает ребёнка со светящимся цветком — создано по тексту.
“A lone astronaut walks through the ruins of a once-busy city, surrounded by abandoned cars, overgrown skyscrapers, and trees growing through cracked streets. She discovers a small child standing inside an old convenience store, holding a glowing flower. The astronaut slowly removes her helmet as birds suddenly rise into the sky and sunlight breaks through the clouds. Emotional science-fiction film, grand post-apocalyptic environment, slow cinematic camera movement, wide establishing shots, intimate facial close-ups, realistic dust particles, warm sunlight contrasting with cold ruins, epic yet hopeful atmosphere.”
Галерея изображение-в-видео WAN 3.0
Посмотрите, как WAN 3.0 оживляет статичный кадр. Ролик ниже создан из одного первого кадра и содержит нативный синхронный звук.
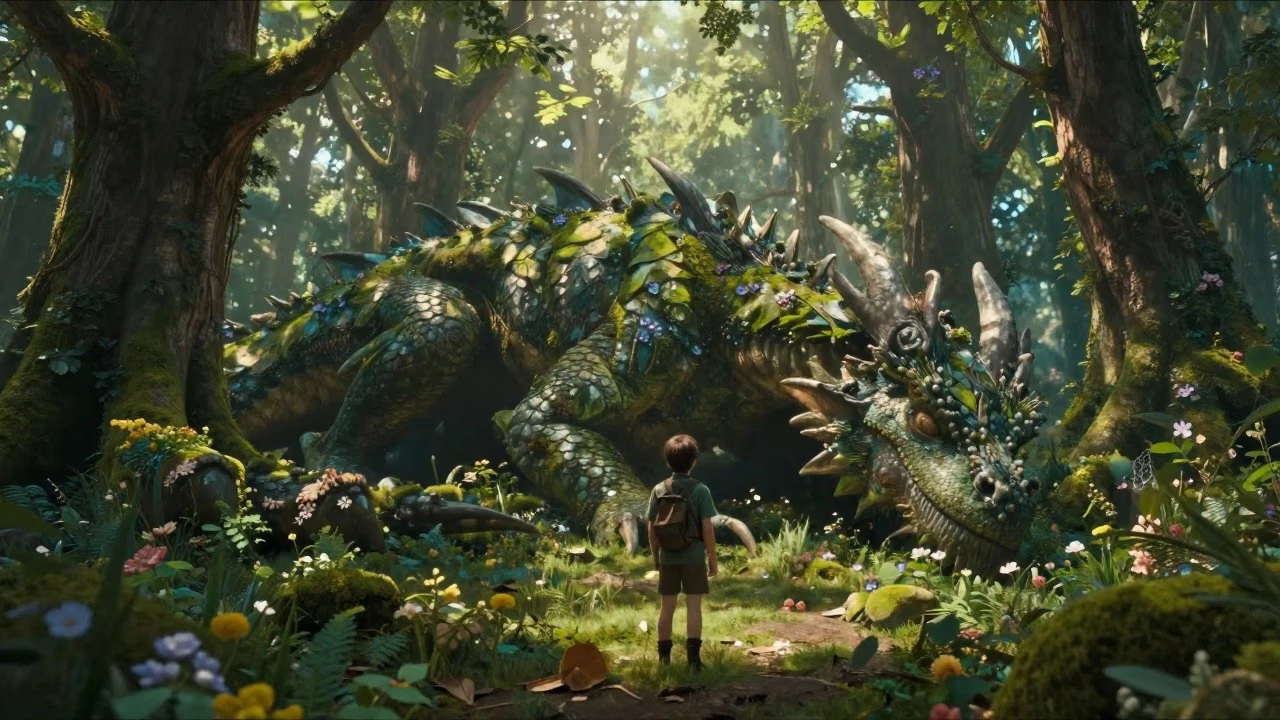
Следопыт встречает лесного дракона
The dragon slowly opens its eyes, leaves move from its breathing, glowing particles float around the forest, the ranger slowly steps forward and reaches out a hand. The camera slowly circles around both characters revealing the enormous scale difference.
Что такое WAN 3.0
Единая видеомодель Alibaba Tongyi Lab, доступная на Dreamega AI
- 2-30sДлительность за один проход
- 1080pМакс. разрешение
- 3Режимы: текст / изображение / референс
- 10Референсных изображений за запуск
WAN 3.0 — единая модель генерации видео от Alibaba Tongyi Lab. Если WAN 2.7 распределяла текст-в-видео, изображение-в-видео, генерацию по референсу и редактирование по отдельным моделям, то WAN 3.0 объединяет их в одну. На Dreamega AI доступны три режима: текст-в-видео создаёт ролик по запросу, изображение-в-видео оживляет первый кадр с необязательным последним кадром, а референс-в-видео объединяет до 10 референсных изображений, 5 видео и 5 аудиодорожек, сохраняя единство персонажа. Каждый режим выдаёт от 2 до 30 секунд за один проход в 480p, 720p или 1080p, с включённым по умолчанию нативным синхронным звуком.
Возможности WAN 3.0
Что единая видеомодель Alibaba даёт генерации по тексту, изображению и референсу
- 01
Одна единая модель
В WAN 2.7 текст-в-видео, изображение-в-видео, генерация по референсу и редактирование были разными моделями. WAN 3.0 объединяет их в одну — поведение одинаково в любом режиме.
- 02
30 секунд за один проход
Задайте длительность от 2 до 30 секунд: весь ролик создаётся за одну генерацию, что позволяет непрерывные движения камеры и съёмку одним кадром без склеек.
- 03
Нативный синхронный звук
Звук рождается вместе с картинкой, а не добавляется потом: тембр речи, окружающие шумы и музыкальный ритм совпадают с действием без отдельного этапа.
- 04
Вывод от 480p до 1080p
480p для быстрых черновиков, 720p для повседневной выдачи, 1080p для финала. Оплата посекундная на каждом уровне, поэтому тесты обходятся дёшево.
- 05
Омни-референсные входы
Референс-в-видео принимает до 10 изображений, 5 видеоклипов и 5 аудиодорожек за запуск, закрепляя персонажа, продукт или локацию на всю сцену.
- 06
Контроль первого и последнего кадра
Изображение-в-видео оживляет загруженный первый кадр и может принять последний кадр, так что вы точно задаёте начало и финал плана.
- 07
Режим глубокого размышления
Включите режим размышления — и модель тщательнее разберёт сложный запрос перед генерацией; это помогает со сценами из нескольких частей и необычной постановкой.
- 08
Пять соотношений сторон
16:9, 9:16, 1:1, 4:3 или 3:4 покрывают широкий экран, вертикальный мобильный формат, квадратные ленты и классическую кадрировку. Режим из изображения может следовать исходнику.
Как пользоваться WAN 3.0 текст-в-видео
Создайте ролик длительностью до 30 секунд по текстовому описанию
- 01
Напишите запрос
Опишите сцену, объект, движение камеры, свет и настроение. Детали помогают, а для сложных идей можно включить режим размышления.
- 02
Задайте длительность, формат и разрешение
Выберите длину от 2 до 30 секунд, одно из пяти соотношений сторон и 480p, 720p или 1080p — в зависимости от того, черновик это или финал.
- 03
Сгенерируйте и скачайте
Нажмите «Создать»: WAN 3.0 отрисует весь ролик за один проход со звуком. Посмотрите результат, скачайте его или перезапустите с изменённым запросом.
Видео о WAN 3.0 на YouTube
Смотрите демонстрации, обзоры и уроки сообщества о возможностях WAN 3.0
- Wan 3.0 Is Here — 30-Second AI Videos in One Pass - Tech With Hamza
- China Did It AGAIN? – 100+ Wan 3.0 AI Videos - Airt
- WAN 3.0 Is Almost Too Good to Be True.. (Review) - Oprelia AI
- Alibaba Just Dropped Wan 3.0 (And It's FREE To Try) - ByteForward
- How to Access Wan 3.0 Uncensored API - Best Alternative to Seedance 2 - Anil Chandra Naidu Matcha
Видео о WAN 3.0 на YouTube
Смотрите демонстрации, обзоры и уроки сообщества о возможностях WAN 3.0
Другие модели
Другие топовые ИИ-модели, которые можно попробовать прямо здесь.
 NEW
FLUX 3
Мультимодальная видеомодель Black Forest Labs: текст, изображение, первый-последний кадр и продление видео с нативным звуком, 5-20 секунд до 1080p
HappyHorse 1.0
Видеомодель №1 от Alibaba с кинематографическим качеством
 NEW
Kling 4.0 Flash
Модель Kling от Kuaishou в 720p: дубли 3–20 секунд со встроенным звуком, референсами и редактированием видео
 NEW
Veo 3.1
Google Veo 3.1 создает кинематографические видео 1080p с нативным аудио и синхронизацией губ
 NEW
Gemini Omni 1.2 Flash
Быстрая видеомодель Google со встроенным звуком: ролики 3–15 с до 4K из текста, изображений, референсов или готового видео
 NEW
Seedance 2.5
Видеомодель нового поколения от ByteDance с нативной генерацией за один дубль длительностью 30 секунд и улучшенной согласованностью кадров в длинных форматах
Цены
Цены
Выберите подходящий для вас план. Никаких скрытых комиссий, никаких сюрпризов.
Одноразово поддерживает оплату криптовалютой (BTC, USDT, ETH, 350+) · Одноразово также поддерживает оплату через T-Bank, YooMoney, SberPay, Visa/Mastercard/Mir · Месячная оплата
Бесплатно-Одноразово
Попробуйте перед покупкой
- 3 видео
- 32 изображений
- Поддержка нескольких моделей
- Текст в видео
- Изображение в видео
- Видео в видео
Показать ещё (+11)
- Постоянный персонаж
- AI-генератор анимации
- Шаблоны и эффекты
- AI-улучшение видео
- Интерактивное сообщество
- Быстрая генерация
- Без водяных знаков
- Больше движений камеры
- Приватность видео
- Защита от копирования
- Приоритетная поддержка
Pro-1 месяц
ПопулярныйУлучшите ваш опыт с ИИ
- 80 видео
- 800 изображений
- 3 задач(Параллельные задачи)
- Поддержка нескольких моделей
- Текст в видео
- Изображение в видео
Показать ещё (+12)
- Видео в видео
- Постоянный персонаж
- AI-генератор анимации
- Шаблоны и эффекты
- AI-улучшение видео
- Интерактивное сообщество
- Быстрая генерация
- Без водяных знаков
- Больше движений камеры
- Приватность видео
- Защита от копирования
- Приоритетная поддержка
Lite-1 месяц
Начните своё путешествие с ИИ
- 30 видео
- 300 изображений
- 3 задач(Параллельные задачи)
- Поддержка нескольких моделей
- Текст в видео
- Изображение в видео
Показать ещё (+12)
- Видео в видео
- Постоянный персонаж
- AI-генератор анимации
- Шаблоны и эффекты
- AI-улучшение видео
- Интерактивное сообщество
- Быстрая генерация
- Без водяных знаков
- Больше движений камеры
- Приватность видео
- Защита от копирования
- Приоритетная поддержка
- Card
- BTC, USDT, ETH и 350+ криптовалют принимаются
Частые вопросы
Распространённые вопросы о генерации видео в WAN 3.0
Остались вопросы?