🎨 Seedream 5.5 — ByteDance の最新画像モデル:ネイティブ透過背景、最大 2K、最大 10 枚の参照画像で編集!


daVinci MagiHuman テキスト/画像から動画生成 オーディオ同期付き
daVinci MagiHumanで動画を作成 - Sand.aiとSII GAIR Labが共同開発した150億パラメータのオープンソース音声動画基盤モデル。テキストや画像から同期した動画と音声を生成、7言語で業界最高のリップシンク精度。最大1080p、5-10秒。シングルストリームTransformerアーキテクチャ、H100 1枚で5秒256p動画をわずか2秒で生成。
daVinci MagiHuman テキストから動画へのギャラリー
daVinci MagiHumanのテキストから動画への生成が持つ映画のような表現力をご体験ください。詳細なテキスト説明から、業界最高水準の7言語対応リップシンクを備えた、同期音声付きの見事な動画を作成できます。
雨の東京の夜
赤いコートを着た女性が、雨の夜にネオンが輝く東京の路地を歩き、きらめく反射が映り込む。
“Rainy night in a neon-lit Tokyo alley, a woman in a red coat walks slowly under an umbrella. Reflections shimmer on wet cobblestones. Handheld camera follows her from behind, bokeh street lights, cinematic color grade, moody atmosphere.”
daVinci MagiHuman 画像から動画ギャラリー
daVinci MagiHumanで静止画を動きのある動画に変換しましょう。リアルな表情、自然な身体の動き、そしてリップシンクされた音声を備えた、シームレスな画像から動画への変換をご体験ください。
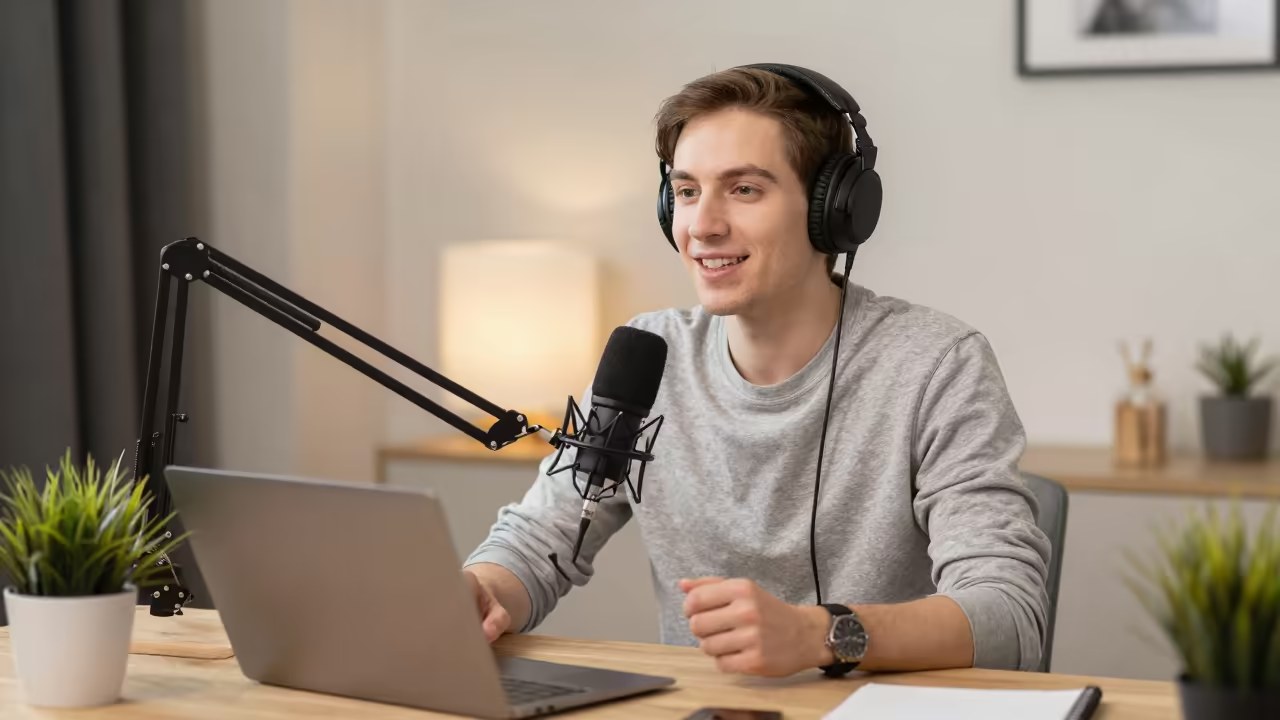
話すポッドキャストホスト
daVinci MagiHumanとは
Sand.aiの150億パラメータオープンソース音声動画基盤モデル、業界最高のリップシンク
- 150億パラメータ
- 1080p最大解像度
- 7対応言語
- 2秒256p生成速度
daVinci MagiHumanは150億パラメータのシングルストリームTransformerで、テキストや画像から同期した動画と音声を共同生成し、7言語で14.6%の単語エラー率という業界最高のリップシンク精度を達成します。
daVinci MagiHumanの強力な機能
daVinci MagiHumanを音声動画生成で卓越させる先進機能をご覧ください
- 01
音声動画同時生成
統一されたシングルストリームTransformerアーキテクチャでself-attentionのみを使用し、1回のパスで同期した動画と音声を生成。別途の音声パイプラインは不要。
- 02
業界最高のリップシンク
リップシンクの単語エラー率14.6%を達成。Ovi 1.1(40.45%)やLTX 2.3(19.23%)を大幅に上回る音声精度ベンチマーク。
- 03
7言語音声対応
英語、中国語(普通話・広東語)、日本語、韓国語、ドイツ語、フランス語で自然な発音と唇の動きを持つ音声同期動画を生成。
- 04
超高速生成
単一のH100 GPUで5秒の256p動画をわずか2秒で生成。8ステップDMD-2蒸留によりclassifier-free guidanceなしで品質を維持。
- 05
デュアル入力モード
テキストプロンプトから動画を作成、または静止画像をアニメーション化。両モードとも設定可能なアスペクト比、解像度、5-10秒の長さに対応。
- 06
最大1080p超解像
潜在空間超解像パイプラインにより256p、540p、720p、1080pの動画を生成。追加のVAEデコード・エンコードオーバーヘッドなし。
- 07
オープンソース Apache 2.0
Apache 2.0ライセンスで完全オープンソース。ベースウェイト、蒸留モデル、超解像モデル、推論コードの完全なスタックを含み、商用利用無制限。
- 08
人間中心の卓越性
デジタルヒューマン生成に特化。表情豊かな顔の動き、リアルな体の動き、フレーム間での一貫したキャラクター保持でプロのトーキングヘッドコンテンツに最適。
daVinci MagiHuman テキストから動画の使い方
テキスト説明から同期オーディオ付き動画を生成
- 01
プロンプトを書く
作成したい動画の詳細な説明を入力してください。最適なリップシンク結果のために、主題、アクション、音声内容、希望する言語を含めてください。
- 02
設定を構成
解像度(256pから1080p)、アスペクト比(16:9または9:16)、長さ(5-10秒)を選択。7つのサポート言語から音声言語を選択。
- 03
動画を生成
生成をクリックすると、daVinci MagiHumanが1回の統一生成パスで同期オーディオとリップシンク音声付きの動画を作成します。
daVinci MagiHuman 画像から動画の使い方
静止画像を同期オーディオ付き動画にアニメーション化
- 01
画像をアップロード
アニメーション化したい人物やシーンのリファレンス画像をアップロード。daVinci MagiHumanはリアルな表情と体の動きの人間中心コンテンツに優れています。
- 02
プロンプトと設定を追加
希望するモーションとスピーチを記述。解像度(256p〜1080p)、アスペクト比、長さ(5-10秒)、7つの対応言語から音声言語を選択。
- 03
アニメーション動画を生成
生成をクリックして画像を自然なモーション、表現力豊かなパフォーマンス、リップシンクオーディオ付きのダイナミック動画に変換します。
daVinci MagiHuman YouTube動画
daVinci MagiHumanの音声動画生成機能を紹介するコミュニティのデモンストレーションとレビューをご覧ください
- daVinci-MagiHuman: Fast Audio-Video Synthesis - AI Research Roundup
- 达芬奇最新开源模型,革命Seedance2.0 DaVinci-MagiHuman:开源音视频生成新标杆,5秒视频2秒出,还能说6种语言! - XIAOXIAO LI
- LTX 2.3, Veo и Sora больше не нужны? Тестируем daVinci-MagiHuman - ServerFlow AI Lab - R&D в области ИИ и LLM
- Ai动画224-化繁为简!daVinci-MagiHuman,快速音视频生成基础模型的单流架构,支持多国语言,音画同步,音色参考-T8 Comfyui教程 - T8star-Aix
daVinci MagiHuman YouTube動画
daVinci MagiHumanの音声動画生成機能を紹介するコミュニティのデモンストレーションとレビューをご覧ください
daVinci MagiHuman X での人気レビュー
X (Twitter) で daVinci MagiHuman について何を言っているか見てみましょう
他のモデルを見る
人気の AI モデルをここでそのまま試せます。
 NEW
FLUX 3
Black Forest Labs のマルチモーダル動画モデル:テキスト・画像・開始/終了フレーム・動画延長、ネイティブ音声付きで5〜20秒、最大1080p
HappyHorse 1.0
Alibaba No.1 動画モデル、シネマティック高品質映像
 NEW
Wan 3.0
統合された WAN モデル:テキスト・画像・参照から動画、ネイティブ音声付きで一度に最長30秒
 NEW
Kling 4.0 Flash
Kuaishou の 720p Kling モデル。3〜20 秒のテイク、ネイティブ音声、リファレンス、動画編集に対応
 NEW
Veo 3.1
Google Veo 3.1はネイティブオーディオとリップシンクを備えたシネマティック1080p動画を作成
 NEW
Gemini Omni 1.2 Flash
音声も生成するGoogleの高速動画モデル。テキスト、画像、リファレンス、既存の動画から、最大4Kで3〜15秒のクリップを作成
料金
料金
あなたに合ったプランを選んでください。隠れた料金や予期せぬ費用はありません。
一回限り は暗号通貨決済に対応 (BTC, USDT, ETH, 350+) · 月間請求
無料-一回限り
購入前にお試し
- 最大 3 動画
- 最大 32 画像
- マルチモデル対応
- テキストから動画
- 画像から動画
- 動画から動画
もっと見る (+11)
- キャラクター一貫性
- AIアニメーション生成
- テンプレートとエフェクト
- AI動画エンハンサー
- インタラクティブコミュニティ
- 高速生成
- 透かしなし出力
- カメラワーク追加
- 動画プライバシー
- コピー保護
- 優先サポート
Pro-1ヶ月
人気AIエクスペリエンスを向上
- 最大 80 動画
- 最大 800 画像
- 3 タスク(並列タスク)
- マルチモデル対応
- テキストから動画
- 画像から動画
もっと見る (+12)
- 動画から動画
- キャラクター一貫性
- AIアニメーション生成
- テンプレートとエフェクト
- AI動画エンハンサー
- インタラクティブコミュニティ
- 高速生成
- 透かしなし出力
- カメラワーク追加
- 動画プライバシー
- コピー保護
- 優先サポート
Lite-1ヶ月
AIの旅を始めよう
- 最大 30 動画
- 最大 300 画像
- 3 タスク(並列タスク)
- マルチモデル対応
- テキストから動画
- 画像から動画
もっと見る (+12)
- 動画から動画
- キャラクター一貫性
- AIアニメーション生成
- テンプレートとエフェクト
- AI動画エンハンサー
- インタラクティブコミュニティ
- 高速生成
- 透かしなし出力
- カメラワーク追加
- 動画プライバシー
- コピー保護
- 優先サポート
- Card
- BTC, USDT, ETH および 350+ 種類の暗号通貨に対応