


🎨 Seedream 5.5 — أحدث نماذج الصور من ByteDance: خلفيات شفافة أصلية، حتى دقة 2K وتحرير بما يصل إلى 10 صور مرجعية!


مولّد فيديو daVinci MagiHuman من النص/الصورة مع مزامنة الصوت
أنشئ مقاطع فيديو باستخدام daVinci MagiHuman - نموذج أساسي مفتوح المصدر للصوت والفيديو بحجم 15 مليار معامل من Sand.ai وSII GAIR Lab. أنشئ فيديو وصوتاً متزامنين من نص أو صور بدقة مزامنة شفاه رائدة في الصناعة عبر 7 لغات. يدعم دقة تصل إلى 1080p بمدة 5-10 ثوانٍ. مدعوم بمعمارية Transformer أحادية التدفق بلا انتباه متقاطع، ينتج فيديو 256p لمدة 5 ثوانٍ في ثانيتين فقط على معالج H100 واحد.
معرض داVinci MagiHuman لتحويل النص إلى فيديو
استمتع بالقوة السينمائية لتوليد الفيديو من النص باستخدام daVinci MagiHuman. أنشئ مقاطع فيديو مذهلة بصوت متزامن من أوصاف نصية مفصّلة، مع مزامنة شفاه رائدة في الصناعة عبر 7 لغات.
ليلة ممطرة في طوكيو
امرأة ترتدي معطفاً أحمر تمشي في زقاق طوكيو المضاء بأضواء النيون في ليلة ممطرة مع انعكاسات متلألئة.
“Rainy night in a neon-lit Tokyo alley, a woman in a red coat walks slowly under an umbrella. Reflections shimmer on wet cobblestones. Handheld camera follows her from behind, bokeh street lights, cinematic color grade, moody atmosphere.”
معرض daVinci MagiHuman لتحويل الصور إلى فيديو
حوّل صورك الثابتة إلى مقاطع فيديو ديناميكية مع daVinci MagiHuman. استمتع بتحويل سلس من الصورة إلى الفيديو مع تعبيرات وجه واقعية، وحركة جسد طبيعية، وصوت متزامن مع حركة الشفاه.
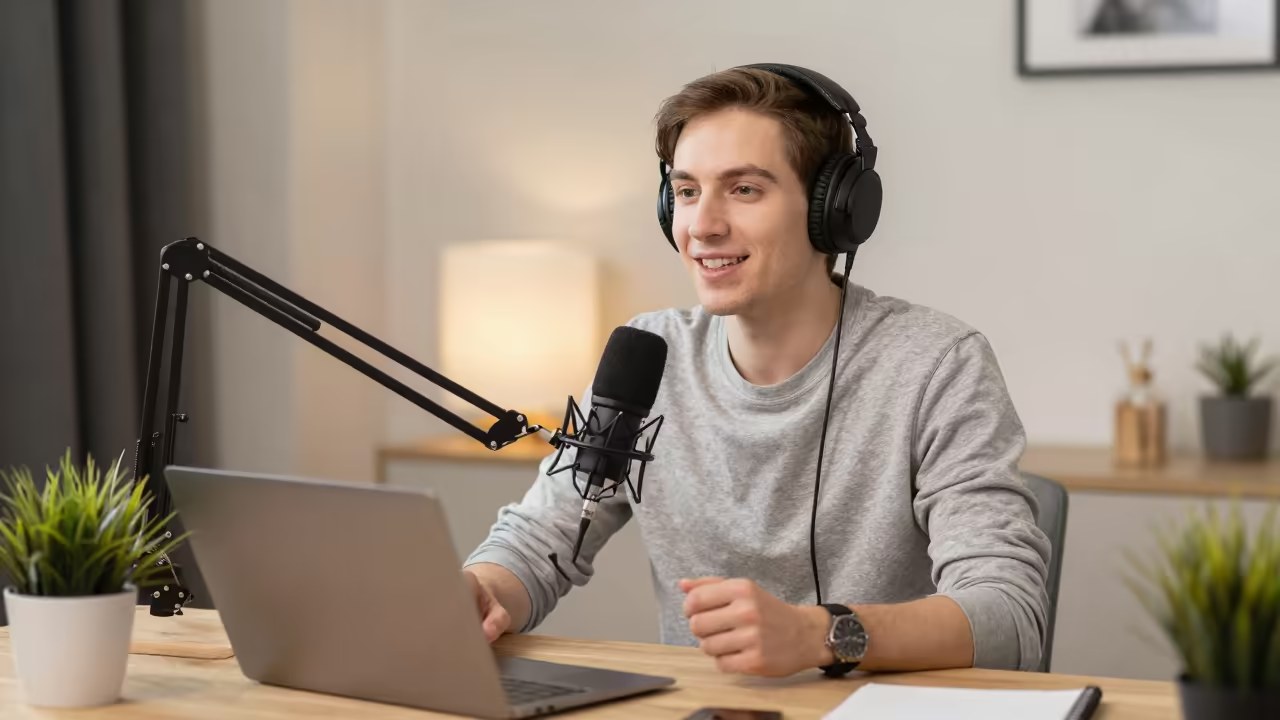
مضيف بودكاست يتحدث
ما هو daVinci MagiHuman
نموذج تأسيسي مفتوح المصدر للصوت والفيديو من Sand.ai بحجم 15 مليار معامل مع أفضل مزامنة للشفاه في فئته
- 15Bالمعاملات
- 1080pأقصى دقة
- 7اللغات المدعومة
- 2sسرعة إنشاء 256p
daVinci MagiHuman هو محول (Transformer) أحادي التدفق بـ 15 مليار معامل ينشئ فيديو وصوتًا متزامنين معًا من النص أو الصور، محققًا دقة رائدة في الصناعة لمزامنة الشفاه بمعدل خطأ كلمات 14.6% عبر 7 لغات.
ميزات daVinci MagiHuman القوية
اكتشف القدرات المتقدمة التي تجعل daVinci MagiHuman استثنائيًا في توليد الصوت والفيديو
- 01
توليد مشترك للصوت والفيديو
أنتج فيديو وصوتًا متزامنين في مرور واحد باستخدام بنية محول أحادية التدفق موحدة تعتمد فقط على الانتباه الذاتي، مما يلغي الحاجة إلى خطوط معالجة صوتية منفصلة.
- 02
مزامنة شفاه رائدة في المجال
حقق معدل خطأ في الكلمات يبلغ 14.6% في مزامنة الشفاه، متفوقًا بشكل كبير على منافسين مثل Ovi 1.1 (40.45%) وLTX 2.3 (19.23%) في معايير دقة الكلام.
- 03
دعم الكلام بـ 7 لغات
أنتج فيديوهات متزامنة مع الكلام باللغات الإنجليزية والصينية (الماندرين والكانتونية) واليابانية والكورية والألمانية والفرنسية بنطق طبيعي وحركات شفاه واقعية.
- 04
توليد فائق السرعة
أنتج فيديو مدته 5 ثوانٍ بدقة 256p في ثانيتين فقط على معالج رسومات H100 واحد. يلغي التقطير DMD-2 المكوّن من 8 خطوات الحاجة إلى التوجيه الخالي من المصنف دون فقدان الجودة.
- 05
وضعا إدخال مزدوجان
أنشئ فيديوهات من طلبات نصية أو حرّك صورًا ثابتة. يدعم كلا وضعي النص إلى فيديو والصورة إلى فيديو نسب عرض إلى ارتفاع ودرجات دقة ومددًا زمنية قابلة للتخصيص من 5 إلى 10 ثوانٍ.
- 06
دقة فائقة تصل إلى 1080p
أنتج فيديوهات بدقة 256p أو 540p أو 720p أو 1080p عبر خط معالجة دقة فائقة في الفضاء الكامن يرفع الدقة دون عبء إضافي لفك وترميز VAE، لإنتاج مخرجات عالية الدقة بكفاءة.
- 07
مفتوح المصدر بترخيص Apache 2.0
مفتوح المصدر بالكامل بموجب ترخيص Apache 2.0 مع مجموعة كاملة تشمل الأوزان الأساسية والنموذج المقطّر ونموذج الدقة الفائقة وكود الاستدلال، للاستخدام التجاري دون قيود.
- 08
تميّز محوره الإنسان
متخصص في توليد البشر الرقميين بأداء وجهي معبّر وحركة جسدية واقعية والحفاظ على اتساق الشخصية عبر الإطارات، لمحتوى احترافي لشخصيات متحدثة.
كيفية استخدام daVinci MagiHuman لتحويل النص إلى فيديو
أنشئ مقاطع فيديو بصوت متزامن من أوصاف نصية
- 01
اكتب وصفك
أدخل وصفًا تفصيليًا للفيديو الذي تريد إنشاءه. أضف الموضوع والحركة ومحتوى الكلام واللغة المطلوبة للحصول على أفضل نتائج مزامنة الشفاه.
- 02
اضبط الإعدادات
اختر الدقة (من 256p إلى 1080p)، ونسبة العرض إلى الارتفاع (16:9 أو 9:16)، والمدة (5-10 ثوانٍ). اختر لغة الكلام من بين 7 خيارات مدعومة.
- 03
أنشئ الفيديو
اضغط على زر الإنشاء وسيقوم daVinci MagiHuman بإنشاء فيديوك بصوت متزامن وكلام متزامن مع الشفاه في مسار إنشاء واحد موحد.
كيفية استخدام daVinci MagiHuman لتحويل الصورة إلى فيديو
حرّك الصور الثابتة إلى مقاطع فيديو بصوت متزامن
- 01
ارفع صورتك
ارفع صورة مرجعية للشخص أو المشهد الذي تريد تحريكه. يتفوق daVinci MagiHuman في المحتوى المرتكز على الأشخاص بتعابير وجه وحركات جسد واقعية.
- 02
أضف الوصف والإعدادات
صف الحركة والكلام المطلوبين. اختر الدقة (من 256p إلى 1080p)، ونسبة العرض إلى الارتفاع، والمدة (5-10 ثوانٍ)، ولغة الكلام من بين 7 خيارات مدعومة.
- 03
أنشئ الفيديو المتحرك
اضغط على زر الإنشاء لتحويل صورتك إلى فيديو ديناميكي بحركة طبيعية وأداء تعبيري وصوت متزامن مع الشفاه في عملية إنشاء واحدة موحدة.
مقاطع فيديو daVinci MagiHuman على يوتيوب
شاهد عروضًا ومراجعات من المجتمع تستعرض قدرات daVinci MagiHuman في توليد الصوت والفيديو
- daVinci-MagiHuman: Fast Audio-Video Synthesis - AI Research Roundup
- 达芬奇最新开源模型,革命Seedance2.0 DaVinci-MagiHuman:开源音视频生成新标杆,5秒视频2秒出,还能说6种语言! - XIAOXIAO LI
- LTX 2.3, Veo и Sora больше не нужны? Тестируем daVinci-MagiHuman - ServerFlow AI Lab - R&D в области ИИ и LLM
- Ai动画224-化繁为简!daVinci-MagiHuman,快速音视频生成基础模型的单流架构,支持多国语言,音画同步,音色参考-T8 Comfyui教程 - T8star-Aix
مقاطع فيديو daVinci MagiHuman على يوتيوب
شاهد عروضًا ومراجعات من المجتمع تستعرض قدرات daVinci MagiHuman في توليد الصوت والفيديو
أبرز تقييمات daVinci MagiHuman على X
اطّلع على آراء الناس حول daVinci MagiHuman على X (تويتر)
استكشف نماذج أخرى
المزيد من أفضل نماذج الذكاء الاصطناعي لتجربتها هنا مباشرة.
 NEW
FLUX 3
نموذج الفيديو متعدد الوسائط من Black Forest Labs: من النص والصورة والإطارين الأول والأخير وتمديد الفيديو مع صوت أصلي، 5-20 ثانية بدقة تصل إلى 1080p
HappyHorse 1.0
نموذج الفيديو الأول من Alibaba بمخرجات سينمائية عالية الجودة
 NEW
Wan 3.0
نموذج WAN موحّد: من النص والصورة والمرجع إلى فيديو، حتى 30 ثانية في تمريرة واحدة مع صوت أصلي
 NEW
Kling 4.0 Flash
نموذج Kling بدقة 720p من Kuaishou: لقطات من 3 إلى 20 ثانية مع صوت أصلي ومراجع وتحرير الفيديو
 NEW
Veo 3.1
Google Veo 3.1 ينشئ فيديوهات سينمائية بدقة 1080p مع صوت أصلي ومزامنة شفاه
 NEW
Gemini Omni 1.2 Flash
نموذج الفيديو السريع من Google مع صوت مدمج: مقاطع من 3 إلى 15 ث حتى 4K من نص أو صور أو مراجع أو فيديو موجود
خطط أسعار الذكاء الاصطناعي
أسعار مرنة للذكاء الاصطناعي
رصيد بنظام الدفع حسب الاستخدام أو خطط اشتراك. بدون رسوم خفية، يمكنك الإلغاء في أي وقت.
مرة واحدة يدعم الدفع بالعملات الرقمية (BTC, USDT, ETH, 350+) · Monthly billing
مجاني-مرة واحدة
جرّب قبل الشراء
- 3 فيديو
- 32 صور
- دعم نماذج متعددة
- نص إلى فيديو
- صورة إلى فيديو
- فيديو إلى فيديو
عرض المزيد (+11)
- شخصية متسقة
- مولّد الرسوم المتحركة
- قوالب وتأثيرات
- تحسين الفيديو بالذكاء الاصطناعي
- مجتمع تفاعلي
- سرعة توليد أعلى
- بدون علامة مائية
- حركة كاميرا أكثر
- خصوصية الفيديو
- حماية النسخ
- دعم ذو أولوية
Pro-1 شهر
الأكثر شيوعاًارتقِ بتجربتك مع الذكاء الاصطناعي
- 80 فيديو
- 800 صور
- 3 مهام(مهام متوازية)
- دعم نماذج متعددة
- نص إلى فيديو
- صورة إلى فيديو
عرض المزيد (+12)
- فيديو إلى فيديو
- شخصية متسقة
- مولّد الرسوم المتحركة
- قوالب وتأثيرات
- تحسين الفيديو بالذكاء الاصطناعي
- مجتمع تفاعلي
- سرعة توليد أعلى
- بدون علامة مائية
- حركة كاميرا أكثر
- خصوصية الفيديو
- حماية النسخ
- دعم ذو أولوية
Lite-1 شهر
ابدأ رحلتك مع الذكاء الاصطناعي
- 30 فيديو
- 300 صور
- 3 مهام(مهام متوازية)
- دعم نماذج متعددة
- نص إلى فيديو
- صورة إلى فيديو
عرض المزيد (+12)
- فيديو إلى فيديو
- شخصية متسقة
- مولّد الرسوم المتحركة
- قوالب وتأثيرات
- تحسين الفيديو بالذكاء الاصطناعي
- مجتمع تفاعلي
- سرعة توليد أعلى
- بدون علامة مائية
- حركة كاميرا أكثر
- خصوصية الفيديو
- حماية النسخ
- دعم ذو أولوية
- Card
- BTC, USDT, ETH و350+ عملة رقمية مقبولة
الأسئلة الشائعة
أسئلة شائعة حول توليد الصوت والفيديو في daVinci MagiHuman
هل لا تزال لديك أسئلة؟