


🎨 Seedream 5.5 — ¡El modelo de imagen más reciente de ByteDance: fondos transparentes nativos, hasta 2K y edición con hasta 10 referencias!


daVinci MagiHuman Generador de Texto/Imagen a Video con Sincronización de Audio
Crea videos con daVinci MagiHuman - un modelo fundamental de audio-video de código abierto de 15B de Sand.ai y SII GAIR Lab. Genera video y audio sincronizados desde texto o imágenes con precisión de lip sync líder en 7 idiomas. Hasta 1080p, 5-10 segundos. Arquitectura Transformer single-stream, video 5s 256p en solo 2 segundos en una H100.
Galería de texto a video de daVinci MagiHuman
Vive el poder cinematográfico de la generación de texto a video de daVinci MagiHuman. Crea videos impresionantes con audio sincronizado a partir de descripciones de texto detalladas, con una sincronización labial líder en la industria en 7 idiomas.
Noche lluviosa en Tokio
Una mujer con abrigo rojo camina por un callejón de Tokio iluminado con neón en una noche lluviosa, con reflejos brillantes.
“Rainy night in a neon-lit Tokyo alley, a woman in a red coat walks slowly under an umbrella. Reflections shimmer on wet cobblestones. Handheld camera follows her from behind, bokeh street lights, cinematic color grade, moody atmosphere.”
Galería de Imagen a Video de daVinci MagiHuman
Transforma tus imágenes estáticas en videos dinámicos con daVinci MagiHuman. Disfruta de una conversión de imagen a video fluida, con expresiones faciales realistas, movimiento corporal natural y audio sincronizado con los labios.
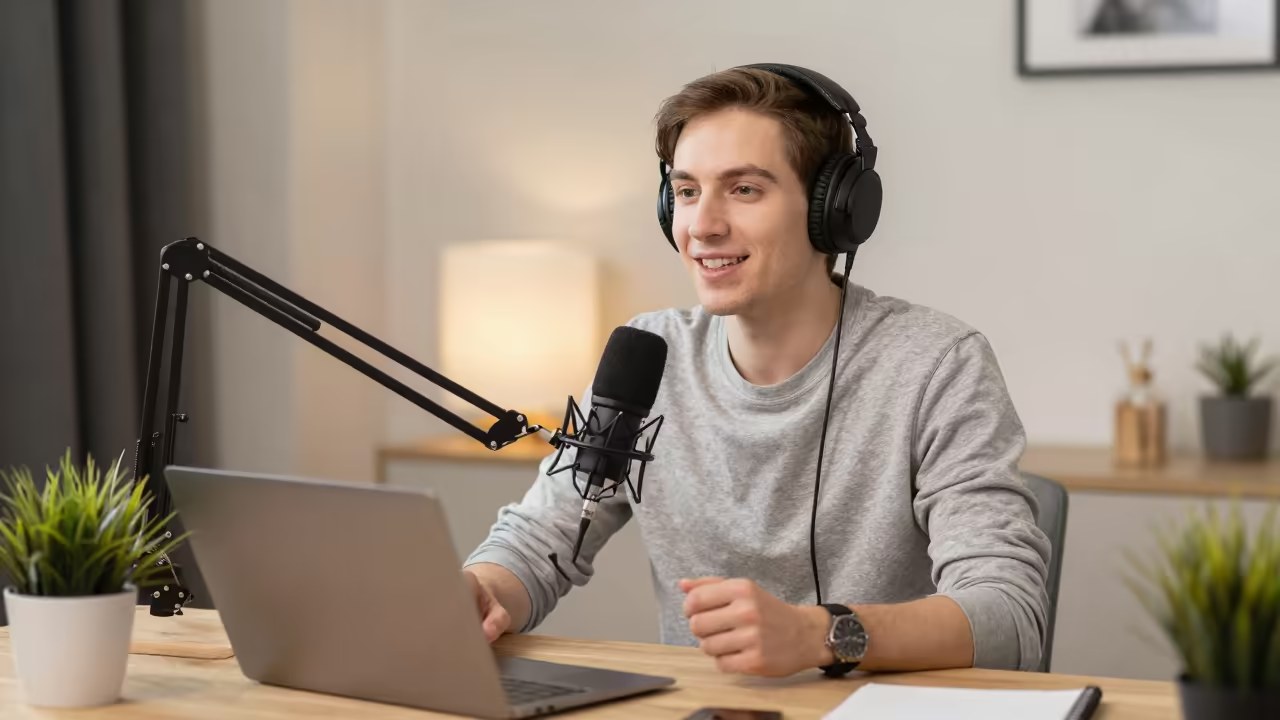
Presentador de pódcast hablando
Qué es daVinci MagiHuman
El modelo fundamental de audio-video de código abierto de 15B de Sand.ai con el mejor lip sync
- 15BParámetros
- 1080pResolución Máx
- 7Idiomas Soportados
- 2sVelocidad 256p
daVinci MagiHuman es un Transformer single-stream de 15 mil millones de parámetros que genera conjuntamente video y audio sincronizados desde texto o imágenes, logrando una precisión de lip sync líder con una tasa de error de palabras del 14,6% en 7 idiomas.
Funcionalidades de daVinci MagiHuman
Descubre las capacidades avanzadas que hacen de daVinci MagiHuman excepcional para la generación de audio-video
- 01
Generación Conjunta de Audio-Video
Genera video y audio sincronizados en una sola pasada usando arquitectura Transformer single-stream con solo self-attention, sin pipeline de audio separado.
- 02
Lip Sync Líder del Sector
Tasa de error de palabras del 14,6% para sincronización labial, superando significativamente a Ovi 1.1 (40,45%) y LTX 2.3 (19,23%) en benchmarks de precisión de habla.
- 03
Soporte de Voz en 7 Idiomas
Genera videos sincronizados con habla en inglés, chino (mandarín y cantonés), japonés, coreano, alemán y francés con pronunciación natural.
- 04
Generación Ultra-Rápida
Produce un video 256p de 5 segundos en solo 2 segundos en una sola GPU H100. Destilación DMD-2 en 8 pasos sin necesidad de guidance sin clasificador.
- 05
Doble Modo de Entrada
Crea videos desde prompts de texto o anima imágenes estáticas. Ambos modos soportan relaciones de aspecto, resoluciones y duraciones de 5 a 10 segundos configurables.
- 06
Super-Resolución Hasta 1080p
Genera videos en 256p, 540p, 720p o 1080p mediante pipeline de super-resolución en espacio latente sin overhead adicional de decodificación-codificación VAE.
- 07
Código Abierto Apache 2.0
Completamente open-source bajo licencia Apache 2.0 con stack completo incluyendo pesos base, modelo destilado, modelo de super-resolución y código de inferencia para uso comercial sin restricciones.
- 08
Excelencia Centrada en el Humano
Especializado en generación de humanos digitales con expresiones faciales expresivas, movimientos corporales realistas y preservación consistente de personajes entre frames.
Cómo usar daVinci MagiHuman Texto a Video
Genera videos con audio sincronizado desde descripciones de texto
- 01
Escribe tu Prompt
Ingresa una descripción detallada del video deseado. Incluye sujeto, acción, contenido de habla e idioma deseado para mejores resultados de lip sync.
- 02
Configura los Ajustes
Selecciona resolución (256p a 1080p), relación de aspecto (16:9 o 9:16) y duración (5-10 segundos). Elige el idioma de voz entre 7 opciones soportadas.
- 03
Genera el Video
Haz clic en generar y daVinci MagiHuman creará tu video con audio sincronizado y lip sync en una sola pasada de generación unificada.
Cómo usar daVinci MagiHuman Imagen a Video
Anima imágenes estáticas en videos con audio sincronizado
- 01
Sube tu Imagen
Sube una imagen de referencia de la persona o escena a animar. daVinci MagiHuman destaca en contenido centrado en humanos con expresiones faciales realistas.
- 02
Añade Prompt y Ajustes
Describe el movimiento y habla deseados. Selecciona resolución (256p a 1080p), relación de aspecto, duración (5-10 segundos) e idioma de voz entre 7 opciones.
- 03
Genera Video Animado
Haz clic para transformar tu imagen en un video dinámico con movimiento natural, actuación expresiva y audio lip-synced en una generación unificada.
Videos de YouTube daVinci MagiHuman
Vea demostraciones y reseñas de la comunidad que muestran las capacidades de generación de audio-video de daVinci MagiHuman
- daVinci-MagiHuman: Fast Audio-Video Synthesis - AI Research Roundup
- 达芬奇最新开源模型,革命Seedance2.0 DaVinci-MagiHuman:开源音视频生成新标杆,5秒视频2秒出,还能说6种语言! - XIAOXIAO LI
- LTX 2.3, Veo и Sora больше не нужны? Тестируем daVinci-MagiHuman - ServerFlow AI Lab - R&D в области ИИ и LLM
- Ai动画224-化繁为简!daVinci-MagiHuman,快速音视频生成基础模型的单流架构,支持多国语言,音画同步,音色参考-T8 Comfyui教程 - T8star-Aix
Videos de YouTube daVinci MagiHuman
Vea demostraciones y reseñas de la comunidad que muestran las capacidades de generación de audio-video de daVinci MagiHuman
daVinci MagiHuman Reseñas populares en X
Mira lo que la gente dice sobre daVinci MagiHuman en X (Twitter)
Explora otros modelos
Más modelos de IA destacados para probar aquí mismo.
 NEW
FLUX 3
Modelo de vídeo multimodal de Black Forest Labs: texto, imagen, primer-último fotograma y extensión de vídeo con audio nativo, 5-20 segundos hasta 1080p
HappyHorse 1.0
Modelo de video nº1 de Alibaba, calidad cinematográfica excepcional
 NEW
Wan 3.0
Modelo WAN unificado: texto, imagen y referencia a vídeo, hasta 30 segundos en una pasada con audio nativo
 NEW
Kling 4.0 Flash
El modelo Kling en 720p de Kuaishou: tomas de 3–20 s con audio nativo, referencias y edición de video
 NEW
Veo 3.1
Google Veo 3.1 crea videos cinematográficos 1080p con audio nativo y sincronización labial
 NEW
Gemini Omni 1.2 Flash
El modelo de vídeo rápido de Google con audio nativo: clips de 3–15 s hasta 4K a partir de texto, imágenes, referencias o un vídeo existente
Precios
Precios
Elige el plan que mejor se adapte a ti. Sin tarifas ocultas, sin sorpresas.
Una vez admite pago con criptomonedas (BTC, USDT, ETH, 350+) · Facturación mensual
Gratis-Una Vez
Prueba antes de comprar
- Hasta 3 videos
- Hasta 32 imágenes
- Soporte multi-modelo
- Texto a video
- Imagen a video
- Video a video
Mostrar más (+11)
- Personaje consistente
- Generador de animación IA
- Plantillas y efectos
- Mejoradores de video IA
- Comunidad interactiva
- Mayor velocidad de generación
- Sin marca de agua
- Más movimientos de cámara
- Visibilidad de video privada
- Protección contra copia
- Soporte prioritario
Pro-1 Mes
PopularMejore su experiencia con IA
- Hasta 80 videos
- Hasta 800 imágenes
- 3 tareas(Tareas paralelas)
- Soporte multi-modelo
- Texto a video
- Imagen a video
Mostrar más (+12)
- Video a video
- Personaje consistente
- Generador de animación IA
- Plantillas y efectos
- Mejoradores de video IA
- Comunidad interactiva
- Mayor velocidad de generación
- Sin marca de agua
- Más movimientos de cámara
- Visibilidad de video privada
- Protección contra copia
- Soporte prioritario
Lite-1 Mes
Comienza tu viaje con IA
- Hasta 30 videos
- Hasta 300 imágenes
- 3 tareas(Tareas paralelas)
- Soporte multi-modelo
- Texto a video
- Imagen a video
Mostrar más (+12)
- Video a video
- Personaje consistente
- Generador de animación IA
- Plantillas y efectos
- Mejoradores de video IA
- Comunidad interactiva
- Mayor velocidad de generación
- Sin marca de agua
- Más movimientos de cámara
- Visibilidad de video privada
- Protección contra copia
- Soporte prioritario
- Card
- BTC, USDT, ETH y 350+ criptomonedas aceptadas
Preguntas Frecuentes
Preguntas comunes sobre la generación de audio-video de daVinci MagiHuman
¿Tienes más preguntas?