


🎨 Seedream 5.5 — ¡El modelo de imagen más reciente de ByteDance: fondos transparentes nativos, hasta 2K y edición con hasta 10 referencias!


Generador WAN 3.0: texto / imagen / referencia a vídeo
Genera vídeo con WAN 3.0, el modelo de vídeo unificado de Tongyi Lab de Alibaba, en Dreamega AI. Escribe un prompt para texto-a-vídeo, anima un primer fotograma con un último fotograma opcional para imagen-a-vídeo, o combina hasta 10 imágenes, 5 vídeos y 5 pistas de audio de referencia. Cada modo produce de 2 a 30 segundos en 480p, 720p o 1080p con audio sincronizado nativo.
Serie de modelos WAN
WAN 3.0 Prime
Versión más rápida de Wan 3.0, con edición y extensión
WAN 2.7
Última versión con generación texto-imagen, edición y video
WAN 2.6
Generación de video mejorada con modos referencia y rápido
WAN 2.5
Generación de video alta calidad desde texto e imagen
WAN 2.2
Generación de video con múltiples relaciones de aspecto
WAN 2.2 Animate
Animación y generación de movimiento especializadas
WAN 2.1
Modelo base con entrada de texto e imagen
Galería de vídeos WAN 3.0
Explora clips generados con WAN 3.0 a partir de prompts de texto. Cada ejemplo se produce en una sola pasada con audio sincronizado nativo.
Astronauta en la ciudad cubierta de vegetación
Una astronauta cruza una ciudad reconquistada por la naturaleza y encuentra a un niño con una flor luminosa, generado a partir de texto.
“A lone astronaut walks through the ruins of a once-busy city, surrounded by abandoned cars, overgrown skyscrapers, and trees growing through cracked streets. She discovers a small child standing inside an old convenience store, holding a glowing flower. The astronaut slowly removes her helmet as birds suddenly rise into the sky and sunlight breaks through the clouds. Emotional science-fiction film, grand post-apocalyptic environment, slow cinematic camera movement, wide establishing shots, intimate facial close-ups, realistic dust particles, warm sunlight contrasting with cold ruins, epic yet hopeful atmosphere.”
Galería imagen-a-vídeo WAN 3.0
Mira cómo WAN 3.0 da vida a una imagen fija. El clip de abajo parte de un solo primer fotograma e incluye audio sincronizado nativo.
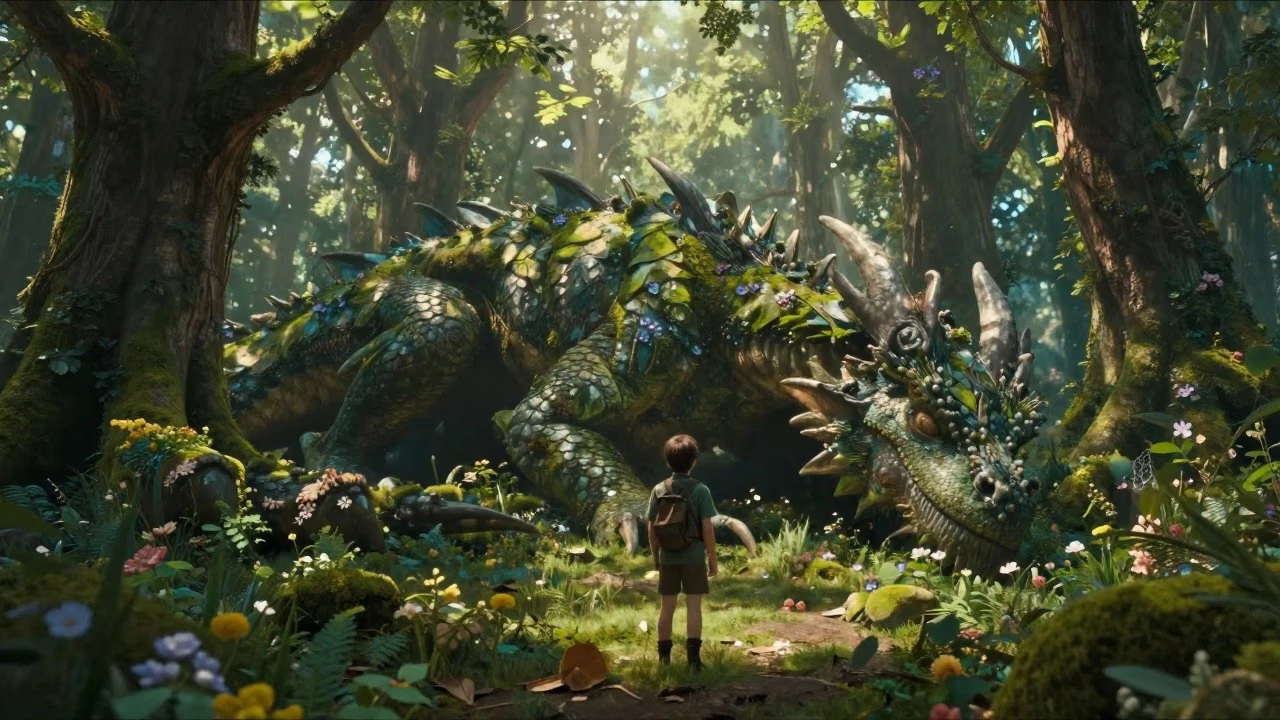
La exploradora y el dragón del bosque
The dragon slowly opens its eyes, leaves move from its breathing, glowing particles float around the forest, the ranger slowly steps forward and reaches out a hand. The camera slowly circles around both characters revealing the enormous scale difference.
Qué es WAN 3.0
El modelo de vídeo unificado de Tongyi Lab de Alibaba, disponible en Dreamega AI
- 2-30sDuración en una pasada
- 1080pResolución máxima
- 3Modos: texto / imagen / referencia
- 10Imágenes de referencia por generación
WAN 3.0 es el modelo unificado de generación de vídeo de Tongyi Lab de Alibaba. Mientras WAN 2.7 repartía texto-a-vídeo, imagen-a-vídeo, generación por referencia y edición entre modelos separados, WAN 3.0 los reúne en uno solo. En Dreamega AI está disponible en tres modos: Texto-a-Vídeo crea un clip a partir de un prompt, Imagen-a-Vídeo anima un primer fotograma con un último fotograma opcional, y Referencia-a-Vídeo combina hasta 10 imágenes, 5 vídeos y 5 pistas de audio de referencia para mantener el mismo sujeto. Cada modo renderiza de 2 a 30 segundos en una sola pasada, en 480p, 720p o 1080p, con audio sincronizado nativo activado por defecto.
Las funciones de WAN 3.0
Lo que el modelo de vídeo unificado de Alibaba aporta a la generación por texto, imagen y referencia
- 01
Un modelo unificado
WAN 2.7 repartía texto-a-vídeo, imagen-a-vídeo, generación por referencia y edición entre modelos separados. WAN 3.0 los reúne en uno solo, con un comportamiento coherente en cualquier modo.
- 02
30 segundos en una pasada
Elige una duración de 2 a 30 segundos: el clip entero se renderiza en una sola generación, lo que permite movimientos de cámara continuos y planos secuencia sin montaje.
- 03
Audio sincronizado nativo
El audio se genera junto con la imagen en lugar de añadirse después: timbre de voz, sonido ambiente y ritmo musical encajan con la acción sin una pasada extra.
- 04
Salida de 480p a 1080p
480p para borradores rápidos, 720p para la entrega habitual y 1080p para el trabajo final. La facturación es por segundo en cada nivel, así que probar sale barato.
- 05
Entradas omni-referencia
Referencia-a-Vídeo admite hasta 10 imágenes, 5 clips de vídeo y 5 pistas de audio de referencia por generación, para fijar un personaje, un producto o un lugar en toda la secuencia.
- 06
Control del primer y último fotograma
Imagen-a-Vídeo anima el primer fotograma que subes y admite opcionalmente un último fotograma, para fijar exactamente dónde empieza y dónde acaba el plano.
- 07
Modo de razonamiento profundo
Con el modo de razonamiento activado, el modelo analiza más a fondo un prompt complejo antes de generar, algo útil en escenas con varios momentos y puestas en escena poco habituales.
- 08
Cinco relaciones de aspecto
16:9, 9:16, 1:1, 4:3 o 3:4 cubren panorámico, vertical móvil, feeds cuadrados y encuadre clásico. Imagen-a-Vídeo también puede seguir la imagen de entrada.
Cómo usar WAN 3.0 Texto a Vídeo
Genera un clip de hasta 30 segundos a partir de una descripción escrita
- 01
Escribe tu prompt
Describe la escena, el sujeto, el movimiento de cámara, la luz y el ambiente. El detalle ayuda, y para ideas complejas puedes activar el modo de razonamiento.
- 02
Ajusta duración, proporción y resolución
Elige una duración de 2 a 30 segundos, una de las cinco relaciones de aspecto y 480p, 720p o 1080p según sea un borrador o la versión final.
- 03
Genera y descarga
Pulsa generar y WAN 3.0 renderiza el clip completo en una pasada con audio sincronizado. Previsualiza el resultado y descárgalo, o repite con el prompt ajustado.
Vídeos de WAN 3.0 en YouTube
Mira demos, análisis y tutoriales de la comunidad que muestran lo que hace WAN 3.0
- Wan 3.0 Is Here — 30-Second AI Videos in One Pass - Tech With Hamza
- China Did It AGAIN? – 100+ Wan 3.0 AI Videos - Airt
- WAN 3.0 Is Almost Too Good to Be True.. (Review) - Oprelia AI
- Alibaba Just Dropped Wan 3.0 (And It's FREE To Try) - ByteForward
- How to Access Wan 3.0 Uncensored API - Best Alternative to Seedance 2 - Anil Chandra Naidu Matcha
Vídeos de WAN 3.0 en YouTube
Mira demos, análisis y tutoriales de la comunidad que muestran lo que hace WAN 3.0
Explora otros modelos
Más modelos de IA destacados para probar aquí mismo.
 NEW
FLUX 3
Modelo de vídeo multimodal de Black Forest Labs: texto, imagen, primer-último fotograma y extensión de vídeo con audio nativo, 5-20 segundos hasta 1080p
HappyHorse 1.0
Modelo de video nº1 de Alibaba, calidad cinematográfica excepcional
 NEW
Kling 4.0 Flash
El modelo Kling en 720p de Kuaishou: tomas de 3–20 s con audio nativo, referencias y edición de video
 NEW
Veo 3.1
Google Veo 3.1 crea videos cinematográficos 1080p con audio nativo y sincronización labial
 NEW
Gemini Omni 1.2 Flash
El modelo de vídeo rápido de Google con audio nativo: clips de 3–15 s hasta 4K a partir de texto, imágenes, referencias o un vídeo existente
Hailuo 2.3
El más reciente modelo de generación de video ultra-rápido de MiniMax AI con arquitectura NCR revolucionaria y velocidades 2,5 veces más rápidas
Precios
Precios
Elige el plan que mejor se adapte a ti. Sin tarifas ocultas, sin sorpresas.
Una vez admite pago con criptomonedas (BTC, USDT, ETH, 350+) · Facturación mensual
Gratis-Una Vez
Prueba antes de comprar
- Hasta 3 videos
- Hasta 32 imágenes
- Soporte multi-modelo
- Texto a video
- Imagen a video
- Video a video
Mostrar más (+11)
- Personaje consistente
- Generador de animación IA
- Plantillas y efectos
- Mejoradores de video IA
- Comunidad interactiva
- Mayor velocidad de generación
- Sin marca de agua
- Más movimientos de cámara
- Visibilidad de video privada
- Protección contra copia
- Soporte prioritario
Pro-1 Mes
PopularMejore su experiencia con IA
- Hasta 80 videos
- Hasta 800 imágenes
- 3 tareas(Tareas paralelas)
- Soporte multi-modelo
- Texto a video
- Imagen a video
Mostrar más (+12)
- Video a video
- Personaje consistente
- Generador de animación IA
- Plantillas y efectos
- Mejoradores de video IA
- Comunidad interactiva
- Mayor velocidad de generación
- Sin marca de agua
- Más movimientos de cámara
- Visibilidad de video privada
- Protección contra copia
- Soporte prioritario
Lite-1 Mes
Comienza tu viaje con IA
- Hasta 30 videos
- Hasta 300 imágenes
- 3 tareas(Tareas paralelas)
- Soporte multi-modelo
- Texto a video
- Imagen a video
Mostrar más (+12)
- Video a video
- Personaje consistente
- Generador de animación IA
- Plantillas y efectos
- Mejoradores de video IA
- Comunidad interactiva
- Mayor velocidad de generación
- Sin marca de agua
- Más movimientos de cámara
- Visibilidad de video privada
- Protección contra copia
- Soporte prioritario
- Card
- BTC, USDT, ETH y 350+ criptomonedas aceptadas
Preguntas frecuentes
Preguntas habituales sobre la generación de vídeo con WAN 3.0
¿Tienes más preguntas?