


🎨 Seedream 5.0 Pro — flagowy model obrazów ByteDance: do 2K, najlepsza w klasie typografia & edycja z wieloma referencjami!


daVinci MagiHuman - generator tekstu / obrazu na wideo z synchronizacją dźwięku
Twórz filmy z daVinci MagiHuman - otwartoźródłowym modelem audio-wideo z 15 mld parametrów od Sand.ai i SII GAIR Lab. Generuj zsynchronizowane wideo i dźwięk z tekstu lub obrazów, z najlepszą w branży dokładnością synchronizacji ruchu ust w 7 językach. Obsługuje rozdzielczość do 1080p i czas trwania 5-10 sekund. Napędzany jednostrumieniową architekturą Transformer bez cross-attention, tworzy 5-sekundowe wideo 256p w zaledwie 2 sekundy na jednym H100.
Galeria daVinci MagiHuman: tekst na wideo
Poznaj filmową moc generowania tekstu na wideo w daVinci MagiHuman. Twórz zachwycające wideo ze zsynchronizowanym dźwiękiem na podstawie szczegółowych opisów tekstowych, z najlepszą w branży synchronizacją ruchu ust w 7 językach.
Deszczowa noc w Tokio
Kobieta w czerwonym płaszczu idzie neonową uliczką Tokio w deszczową noc, wśród migoczących odbić.
“Rainy night in a neon-lit Tokyo alley, a woman in a red coat walks slowly under an umbrella. Reflections shimmer on wet cobblestones. Handheld camera follows her from behind, bokeh street lights, cinematic color grade, moody atmosphere.”

Galeria daVinci MagiHuman: obraz na wideo
Zamień statyczne obrazy w dynamiczne wideo z daVinci MagiHuman. Płynna konwersja obrazu na wideo z realistyczną mimiką, naturalnym ruchem ciała i dźwiękiem zsynchronizowanym z ruchem ust.
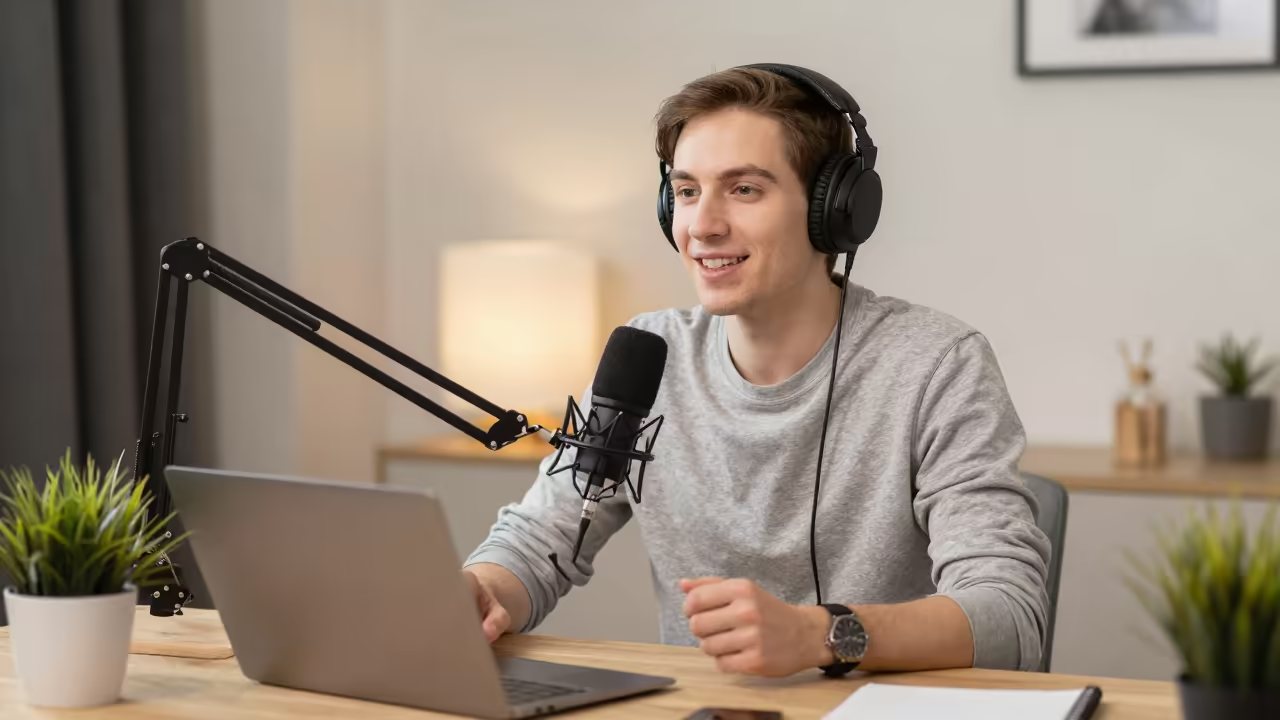
Mówiący prowadzący podcast
Czym jest daVinci MagiHuman
Otwartoźródłowy model podstawowy audio-wideo od Sand.ai o 15 mld parametrów, z najlepszą w klasie synchronizacją ruchu ust (lip sync)
- 15BParametry
- 1080pMaks. rozdzielczość
- 7Obsługiwane języki
- 2sSzybkość generowania w 256p
daVinci MagiHuman to jednostrumieniowy Transformer z 15 miliardami parametrów, który wspólnie generuje zsynchronizowane wideo i dźwięk z tekstu lub obrazów, osiągając czołową w branży dokładność lip syncu przy współczynniku błędu słów 14.6% w 7 językach.
Zaawansowane funkcje daVinci MagiHuman
Poznaj zaawansowane możliwości, dzięki którym daVinci MagiHuman jest wyjątkowy w generowaniu dźwięku i obrazu
- 01
Wspólne generowanie dźwięku i obrazu
Generuj zsynchronizowane wideo i dźwięk w jednym przebiegu dzięki jednolitej, jednostrumieniowej architekturze Transformer opartej wyłącznie na self-attention — bez potrzeby osobnego potoku audio.
- 02
Najlepsza na rynku synchronizacja ruchu ust
Współczynnik błędu słów przy synchronizacji ruchu ust wynosi 14.6% — znacznie lepiej niż u konkurentów takich jak Ovi 1.1 (40.45%) czy LTX 2.3 (19.23%) w testach dokładności mowy.
- 03
Obsługa mowy w 7 językach
Generuj wideo z mową zsynchronizowaną z obrazem po angielsku, chińsku (mandaryński i kantoński), japońsku, koreańsku, niemiecku i francusku, z naturalną wymową i ruchem ust.
- 04
Błyskawiczne generowanie
Stwórz 5-sekundowe wideo w 256p w zaledwie 2 sekundy na pojedynczym GPU H100. 8-krokowa destylacja DMD-2 eliminuje potrzebę classifier-free guidance bez straty jakości.
- 05
Dwa tryby wejścia
Twórz wideo z promptów tekstowych albo animuj nieruchome zdjęcia. Tryby tekst na wideo i obraz na wideo obsługują konfigurowalne proporcje obrazu, rozdzielczości i czas trwania od 5 do 10 sekund.
- 06
Superrozdzielczość do 1080p
Generuj wideo w 256p, 540p, 720p lub 1080p dzięki potokowi superrozdzielczości w przestrzeni latentnej, który powiększa obraz bez dodatkowego narzutu dekodowania i kodowania VAE, co daje wydajny materiał w wysokiej rozdzielczości.
- 07
Otwarte źródła na Apache 2.0
W pełni otwarty na licencji Apache 2.0, z kompletnym stosem: wagami bazowymi, modelem destylowanym, modelem superrozdzielczości i kodem inferencji — do nieograniczonego użytku komercyjnego.
- 08
Mistrzostwo w scenach z człowiekiem
Wyspecjalizowany w generowaniu cyfrowych ludzi: ekspresyjna mimika, realistyczny ruch ciała i spójna postać w kolejnych klatkach — z myślą o profesjonalnych materiałach typu talking head.

Jak korzystać z daVinci MagiHuman tekst na wideo
Generuj wideo ze zsynchronizowanym dźwiękiem na podstawie opisów tekstowych
- 01
Napisz swój prompt
Wpisz szczegółowy opis filmu, który chcesz stworzyć. Uwzględnij bohatera, akcję, treść wypowiedzi i wybrany język, aby uzyskać najlepszą synchronizację ruchu ust.
- 02
Skonfiguruj ustawienia
Wybierz rozdzielczość (od 256p do 1080p), proporcje obrazu (16:9 lub 9:16) i czas trwania (5–10 sekund). Wskaż język wypowiedzi spośród 7 obsługiwanych.
- 03
Wygeneruj wideo
Kliknij generuj, a daVinci MagiHuman stworzy Twoje wideo ze zsynchronizowanym dźwiękiem i wypowiedzią dopasowaną do ruchu ust w jednym przebiegu generowania.
Jak korzystać z daVinci MagiHuman obraz na wideo
Animuj nieruchome obrazy i zamieniaj je w wideo ze zsynchronizowanym dźwiękiem
- 01
Prześlij swój obraz
Prześlij obraz referencyjny osoby lub sceny, którą chcesz ożywić. daVinci MagiHuman najlepiej radzi sobie z treściami z ludźmi — realistyczną mimiką i ruchem ciała.
- 02
Dodaj prompt i ustawienia
Opisz oczekiwany ruch i wypowiedź. Wybierz rozdzielczość (od 256p do 1080p), proporcje obrazu, czas trwania (5–10 sekund) oraz język wypowiedzi spośród 7 obsługiwanych.
- 03
Wygeneruj animowane wideo
Kliknij generuj, aby zamienić obraz w dynamiczne wideo z naturalnym ruchem, ekspresyjną grą i dźwiękiem zsynchronizowanym z ruchem ust — wszystko w jednym przebiegu.
Filmy o daVinci MagiHuman na YouTube
Obejrzyj prezentacje i recenzje społeczności pokazujące możliwości generowania audio i wideo w daVinci MagiHuman
- daVinci-MagiHuman: Fast Audio-Video Synthesis - AI Research Roundup
- 达芬奇最新开源模型,革命Seedance2.0 DaVinci-MagiHuman:开源音视频生成新标杆,5秒视频2秒出,还能说6种语言! - XIAOXIAO LI
- LTX 2.3, Veo и Sora больше не нужны? Тестируем daVinci-MagiHuman - ServerFlow AI Lab - R&D в области ИИ и LLM
- Ai动画224-化繁为简!daVinci-MagiHuman,快速音视频生成基础模型的单流架构,支持多国语言,音画同步,音色参考-T8 Comfyui教程 - T8star-Aix
Filmy o daVinci MagiHuman na YouTube
Obejrzyj prezentacje i recenzje społeczności pokazujące możliwości generowania audio i wideo w daVinci MagiHuman
Popularne opinie o daVinci MagiHuman na X
Zobacz, co ludzie mówią o daVinci MagiHuman na X (Twitterze)
Poznaj inne modele
Więcej czołowych modeli AI do wypróbowania tutaj.
 NEW
FLUX 3
Multimodalny model wideo Black Forest Labs: tekst, obraz, klatka początkowa i końcowa oraz przedłużanie wideo z natywnym dźwiękiem, od 5 do 20 sekund w rozdzielczości do 1080p
HappyHorse 1.0
Model wideo nr 1 od Alibaby, filmowa jakość wyników
 NOWOŚĆ
Wan 3.0
Zunifikowany model WAN: tekst, obraz i referencja na wideo, do 30 sekund w jednym przebiegu z natywnym dźwiękiem
 NEW
Kling 4.0 Flash
Model Kling 720p od Kuaishou: ujęcia 3–20 s z natywnym dźwiękiem, referencje i edycja wideo
 NEW
Veo 3.1
Google Veo 3.1 tworzy filmowe wideo w 1080p z natywnym dźwiękiem i synchronizacją ruchu ust (lip sync)
 NOWOŚĆ
Gemini Omni Flash
Szybki multimodalny model krótkich filmów od Google ze zsynchronizowanym natywnym dźwiękiem, obsługujący tekst na wideo, obraz na wideo, referencję na wideo i edycję wideo
Plany cenowe AI
Elastyczny cennik AI
Kredyty kupowane w miarę potrzeb albo plany subskrypcyjne. Bez ukrytych opłat, anulujesz w każdej chwili.
Jednorazowo obsługuje płatności kryptowalutami (BTC, USDT, ETH, 350+) · Monthly billing
Free-Jednorazowo
Try before you buy
- Up to 3 videos
- Up to 32 images
- Multi-Model Support
- Text to Video
- Image to Video
- Video to Video
Pokaż więcej (+11)
- Consistent Character
- AI Animation Generator
- Templates & Effects
- AI Video Enhancers
- Interactive Community
- Faster Generation Speed
- No-watermark Outputs
- More Camera Movement
- Private Video Visibility
- Copy Protection
- Priority Support
Pro-1 miesiąc
PopularnyElevate your AI experience
- Up to 80 videos
- Up to 800 images
- 3 tasks(Parallel Tasks)
- Multi-Model Support
- Text to Video
- Image to Video
Pokaż więcej (+12)
- Video to Video
- Consistent Character
- AI Animation Generator
- Templates & Effects
- AI Video Enhancers
- Interactive Community
- Faster Generation Speed
- No-watermark Outputs
- More Camera Movement
- Private Video Visibility
- Copy Protection
- Priority Support
Lite-1 miesiąc
Start your AI journey
- Up to 30 videos
- Up to 300 images
- 3 tasks(Parallel Tasks)
- Multi-Model Support
- Text to Video
- Image to Video
Pokaż więcej (+12)
- Video to Video
- Consistent Character
- AI Animation Generator
- Templates & Effects
- AI Video Enhancers
- Interactive Community
- Faster Generation Speed
- No-watermark Outputs
- More Camera Movement
- Private Video Visibility
- Copy Protection
- Priority Support
- Card
- Akceptujemy kryptowaluty (BTC, USDT, ETH, 350+)
Najczęściej zadawane pytania
Najczęstsze pytania o generowanie dźwięku i wideo w daVinci MagiHuman
Masz jeszcze pytania?