


FLUX 3 - generator wideo z tekstu / obrazu / pierwszej i ostatniej klatki / przedłużenia
Generuj wideo z FLUX 3, multimodalnym modelem z najwyższej półki od Black Forest Labs, na Dreamega AI. Napisz prompt w trybie tekst na wideo, ożyw obraz referencyjny w trybie obraz na wideo, połącz klatkę początkową z końcową albo przedłuż istniejący klip MP4. Każdy tryb renderuje od 5 do 20 sekund w 720p lub 1080p z natywnym, zsynchronizowanym dźwiękiem i dialogami w wielu językach.
Seria modeli Flux
Flux 2 Max
Najwyższa półka Flux 2 — generowanie obrazów z maksymalną jakością i detalem
Flux 2 Pro
Profesjonalne generowanie obrazów Flux 2 z lepszą zgodnością z promptem
Flux 2 Flex
Elastyczny model Flux 2 do wszechstronnego tworzenia i edycji obrazów
Flux 2 Klein
Kompaktowy model Flux 2 zoptymalizowany pod szybkie generowanie
Flux Kontext
Model Flux rozumiejący kontekst, do zamiany tekstu na obraz i edycji obrazów
Flux Krea
Kreatywny model Flux dostrojony do artystycznych i stylizowanych efektów
Flux Pro Ultra
Generowanie obrazów Flux Pro w ultrawysokiej rozdzielczości
Flux Dev
Model Flux z otwartymi wagami, idealny do rozwoju i eksperymentów
Flux Schnell
Najszybszy model Flux do błyskawicznego generowania obrazów
Galeria wideo FLUX 3
Przejrzyj klipy wygenerowane w FLUX 3 z promptów tekstowych. Każdy przykład renderuje się w jednym przebiegu, z natywnym, zsynchronizowanym dźwiękiem.
Kurier spóźniony o pięćdziesiąt lat
Kurier na rowerze dociera pod drzwi mieszkania w czasie burzy i spotyka samego siebie po latach — wygenerowane z tekstu.
“A young bicycle courier arrives at an apartment door during a thunderstorm, but the digital display shows a date fifty years in the future. The scene opens with a fast tracking shot following him through wet neon streets, then becomes completely still as the door opens. An elderly man with the same face stands inside and looks at him in shock. The camera slowly rotates around both characters while lightning illuminates the corridor. The food bag begins glowing, and nearby objects float into the air. Emotional science-fiction mystery, realistic acting, controlled camera movement, cinematic neon lighting.”
Galeria FLUX 3 obraz na wideo
Zobacz, jak FLUX 3 ożywia nieruchome obrazy. Pierwszy klip animuje pojedynczy obraz referencyjny, drugi łączy klatkę początkową z końcową przejściem prowadzonym promptem.
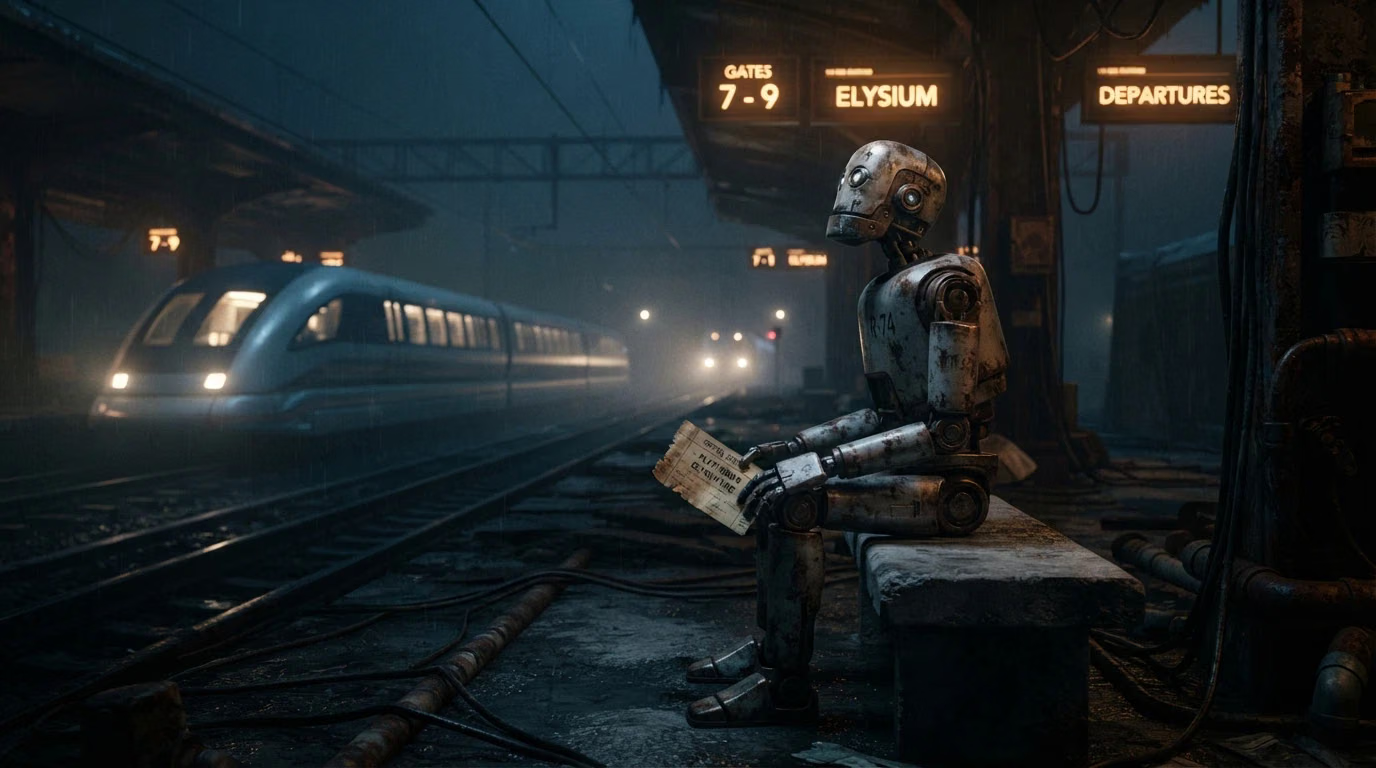
Robot na opuszczonym peronie
The old robot sits alone on an abandoned train platform, holding a faded ticket. Its head slowly rises as distant lights appear along the tracks. The station signs begin illuminating one by one, and a futuristic train silently enters the platform. The camera begins with a close-up of the ticket, tracks across the robot's weathered body, then cranes upward as the train arrives. Emotional science-fiction, quiet storytelling, atmospheric fog, warm and cold light contrast.
Galeria przedłużania wideo FLUX 3
Kontynuuj istniejący klip nowym ujęciem. FLUX 3 podejmuje tam, gdzie kończy się materiał źródłowy, i zachowuje ciągłość postaci, światła i ruchu.
Szkielet w muzeum ożywa
Continue directly as the dinosaur skeleton begins moving. It carefully steps down from the exhibition platform, sending small bones and dust across the floor. The paleontologist runs through the gallery while other fossil displays begin moving behind glass cases. The camera tracks beside her, then swings around as she reaches the museum entrance and finds a living prehistoric jungle outside instead of the city. Maintain the same character, clothing, museum layout, lighting, and movement continuity.
Filmy o FLUX 3 na YouTube
Obejrzyj dema, recenzje i poradniki społeczności pokazujące, co potrafi FLUX 3
- FLUX 3 Is Here — Everything You NEED to Know - ElevenLabs
- Introducing FLUX 3 - Black Forest Labs
- Black Forest Labs FLUX 3: First Look - Bryan Software
- 100+ FLUX 3 AI Videos Scarily Close to Real Life - Airt
- Flux 3 Review: Everything You Need to Know (2026) - Thrive Media
- FLUX 3 - Incredible AI Video Model - Demo Reel - Jerrod Lew
Filmy o FLUX 3 na YouTube
Obejrzyj dema, recenzje i poradniki społeczności pokazujące, co potrafi FLUX 3
Popularne opinie o FLUX 3 na X
Zobacz, co ludzie mówią o FLUX 3 na X (Twitterze)
Czym jest FLUX 3
Multimodalny model frontier od Black Forest Labs do wideo z natywnym dźwiękiem, dostępny w Dreamega AI
- · 015-20sDługość klipu
- · 021080pMaks. rozdzielczość
- · 034Tryby: tekst / obraz / początek-koniec / przedłużanie
- · 047Proporcje obrazu
FLUX 3 to pierwszy multimodalny model frontier od Black Forest Labs: zamiast trenować osobne systemy do obrazu, wideo i dźwięku, uczy się wszystkich trzech naraz w jednej wspólnej architekturze, a ten sam szkielet służy też do przewidywania ruchów robotów. Wersja wideo generuje klipy o długości do 20 sekund z natywnym, zsynchronizowanym dźwiękiem, wielojęzycznymi dialogami z lip syncem i kinową kontrolą kamery. W Dreamega AI jest dostępny w czterech trybach: tekst na wideo buduje klip z napisanego promptu, obraz na wideo animuje obraz referencyjny, początek-koniec łączy dwie klatki kluczowe, a przedłużanie wideo kontynuuje istniejący klip MP4. Każdy tryb renderuje od 5 do 20 sekund w 720p lub 1080p.
Zaawansowane funkcje FLUX 3
Co multimodalny model Black Forest Labs wnosi do generowania wideo z tekstu, obrazu i klipu
- Feature 01 / 08
Jeden model multimodalny
FLUX 3 uczy się obrazu, wideo i dźwięku razem, w jednej wspólnej architekturze, zamiast sklejać osobne systemy — dzięki temu ruch, dźwięk i obraz wynikają z tego samego rozumienia sceny.
- Feature 02 / 08
Natywnie zsynchronizowany dźwięk
Dialogi, efekty dźwiękowe i tło akustyczne powstają w tym samym przebiegu co wideo i są powiązane z tym, co dzieje się na ekranie. Dźwięk jest domyślnie włączony i nie podnosi kosztu w kredytach.
- Feature 03 / 08
Wielojęzyczne dialogi z synchronizacją ruchu ust
Postacie mogą mówić po angielsku, chińsku, hiszpańsku, francusku, niemiecku, japońsku, portugalsku, rosyjsku, włosku, w hindi i nie tylko, a ruch ust jest dopasowany do wypowiadanych słów.
- Feature 04 / 08
Do 20 sekund na klip
Wybierz dowolną pełną liczbę sekund od 5 do 20, a cały klip wyrenderuje się w jednym generowaniu — wystarczająco długo na scenę z kilkoma zwrotami albo pełny ruch kamery.
- Feature 05 / 08
Kontrola klatki początkowej i końcowej
Prześlij klatkę początkową i końcową, a FLUX 3 wygeneruje przejście między nimi, trzymając się twojego promptu co do akcji, ruchu kamery i nastroju po drodze.
- Feature 06 / 08
Wydłużanie wideo
Przedłuż istniejący klip MP4 o długości do 15 sekund o nowe ujęcie trwające od 5 do 20 sekund, zachowując te same postacie, ubrania, światło i ciągłość ruchu.
- Feature 07 / 08
Wyjście w 720p i 1080p
Wybierz 720p na szkice i publikacje w social mediach albo 1080p na wersje finalne. Rozliczenie jest sekundowe na obu poziomach, więc krótkie testy pozostają tanie, a pełną cenę płacisz tylko za finał.
- Feature 08 / 08
Siedem proporcji obrazu
Renderuj w 21:9, 2:1, 16:9, 4:3, 1:1, 3:4 lub 9:16, by pokryć ultraszeroki format filmowy, panoramę, kwadratowe feedy i pionowe shorty bez późniejszego przekadrowywania.
Jak używać FLUX 3 w trybie tekst na wideo
Wygeneruj klip od 5 do 20 sekund z dźwiękiem na podstawie opisu tekstowego
Napisz swój prompt
Opisz scenę, temat, ruch kamery, oświetlenie i nastrój. Jeśli chcesz dialogi, podaj kwestie w cudzysłowie i wskaż język.
Najczęściej zadawane pytania
Najczęstsze pytania o generowanie wideo z FLUX 3
Masz jeszcze pytania?
Elastyczny cennik AI
Kredyty kupowane w miarę potrzeb albo plany subskrypcyjne. Bez ukrytych opłat, anulujesz w każdej chwili.
Jednorazowo obsługuje płatności kryptowalutami (BTC, USDT, ETH, 350+)
Monthly billing