


WAN 3.0 – generator wideo z tekstu, obrazu lub materiałów referencyjnych
Generuj wideo modelem WAN 3.0, zunifikowanym modelem wideo Alibaba Tongyi Lab, w Dreamega AI. Napisz prompt, aby zamienić tekst na wideo, ożyw pierwszą klatkę z opcjonalną ostatnią klatką w trybie obraz na wideo albo połącz do 10 obrazów referencyjnych, 5 wideo referencyjnych i 5 referencyjnych ścieżek dźwiękowych w trybie referencje na wideo. Każdy tryb renderuje od 2 do 30 sekund w 480p, 720p lub 1080p z natywnym, zsynchronizowanym dźwiękiem.
Seria modeli WAN
WAN 2.7
Najnowszy WAN z zamianą tekstu na obraz, edycją obrazów i generowaniem wideo
WAN 2.6
Ulepszone generowanie wideo z trybami referencje na wideo i flash
WAN 2.5
Wysokiej jakości generowanie tekst na wideo i obraz na wideo
WAN 2.2
Wszechstronne generowanie wideo w wielu proporcjach obrazu
WAN 2.2 Animate
Wyspecjalizowane generowanie animacji i ruchu
WAN 2.1
Bazowy model generowania wideo z wejściem tekstowym i obrazowym
Galeria wideo WAN 3.0
Przeglądaj klipy wygenerowane w WAN 3.0 z promptów tekstowych. Każdy przykład powstaje w jednym przebiegu, z natywnym zsynchronizowanym dźwiękiem.
Astronauta w zarośniętym mieście
Samotny astronauta przemierza odzyskane przez naturę miasto i spotyka dziecko trzymające świecący kwiat — wygenerowane z tekstu.
“A lone astronaut walks through the ruins of a once-busy city, surrounded by abandoned cars, overgrown skyscrapers, and trees growing through cracked streets. She discovers a small child standing inside an old convenience store, holding a glowing flower. The astronaut slowly removes her helmet as birds suddenly rise into the sky and sunlight breaks through the clouds. Emotional science-fiction film, grand post-apocalyptic environment, slow cinematic camera movement, wide establishing shots, intimate facial close-ups, realistic dust particles, warm sunlight contrasting with cold ruins, epic yet hopeful atmosphere.”
Galeria WAN 3.0 obraz na wideo
Zobacz, jak WAN 3.0 ożywia nieruchomy obraz. Klip poniżej powstał z jednego obrazu pierwszej klatki i renderuje się z natywnym, zsynchronizowanym dźwiękiem.
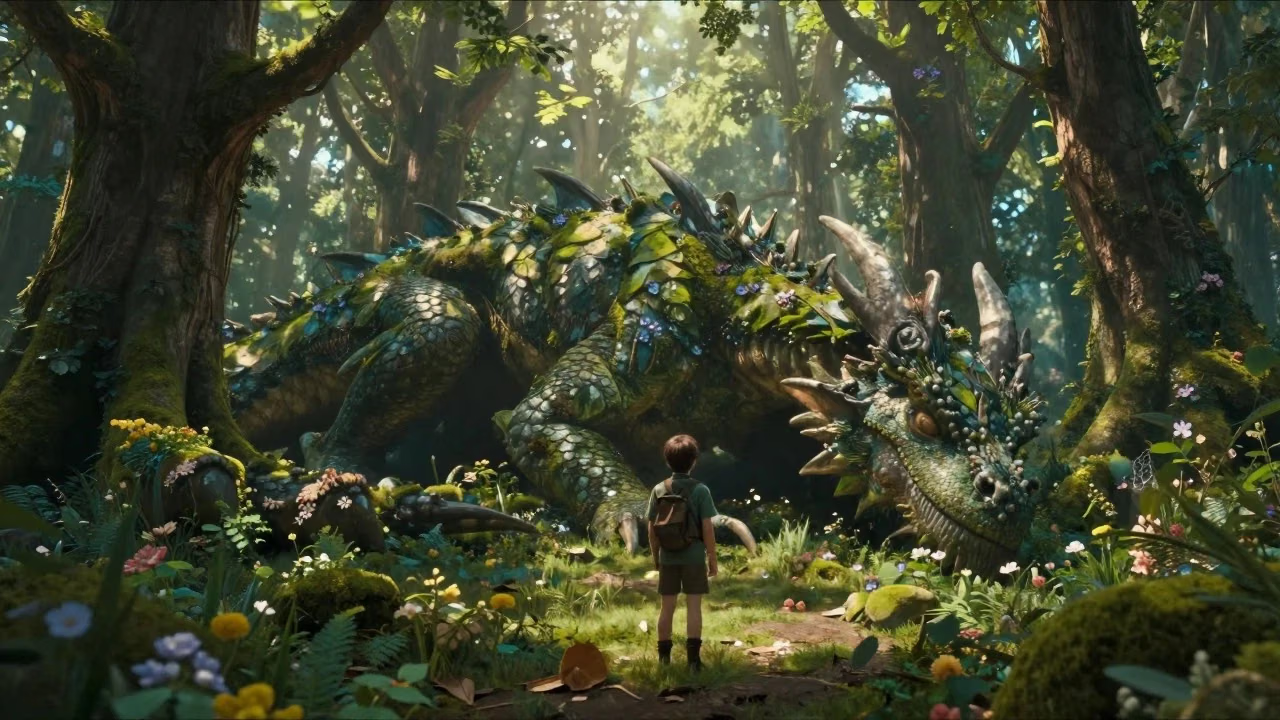
Łowca spotyka leśnego smoka
The dragon slowly opens its eyes, leaves move from its breathing, glowing particles float around the forest, the ranger slowly steps forward and reaches out a hand. The camera slowly circles around both characters revealing the enormous scale difference.
Filmy o WAN 3.0 na YouTube
Obejrzyj dema, recenzje i poradniki społeczności pokazujące, co potrafi WAN 3.0
- Wan 3.0 Is Here — 30-Second AI Videos in One Pass - Tech With Hamza
- China Did It AGAIN? – 100+ Wan 3.0 AI Videos - Airt
- WAN 3.0 Is Almost Too Good to Be True.. (Review) - Oprelia AI
- Alibaba Just Dropped Wan 3.0 (And It's FREE To Try) - ByteForward
- How to Access Wan 3.0 API - Best Alternative to Seedance 2 - Anil Chandra Naidu Matcha
Filmy o WAN 3.0 na YouTube
Obejrzyj dema, recenzje i poradniki społeczności pokazujące, co potrafi WAN 3.0
Czym jest WAN 3.0
Zunifikowany model wideo od Alibaba Tongyi Lab, dostępny na Dreamega AI
- · 012-30sDługość w jednym przebiegu
- · 021080pMaks. rozdzielczość
- · 033Tryby: tekst / obraz / referencja
- · 0410Obrazów referencyjnych na jedno uruchomienie
WAN 3.0 to zunifikowany model generowania wideo od Alibaba Tongyi Lab. Tam, gdzie WAN 2.7 rozdzielał generowanie wideo z tekstu, wideo z obrazu, generowanie z referencji i edycję na osobne modele, WAN 3.0 łączy je w jeden. Na Dreamega AI dostępny jest w trzech trybach: Tekst na wideo tworzy klip z opisu, Obraz na wideo animuje pierwszą klatkę z opcjonalną klatką ostatnią, a Referencja na wideo łączy do 10 obrazów referencyjnych, 5 wideo referencyjnych i 5 referencyjnych ścieżek audio, aby zachować spójność bohatera. Każdy tryb renderuje od 2 do 30 sekund w jednym przebiegu w 480p, 720p albo 1080p, z domyślnie włączonym natywnym, zsynchronizowanym dźwiękiem.
Zaawansowane funkcje WAN 3.0
Co ujednolicony model wideo od Alibaby wnosi do generowania z tekstu, obrazu i referencji
- Feature 01 / 08
Jeden ujednolicony model
WAN 2.7 rozdzielał tekst na wideo, obraz na wideo, generowanie z referencji i edycję pomiędzy osobne modele. WAN 3.0 łączy je w jeden model, więc zachowanie pozostaje spójne niezależnie od trybu, od którego zaczynasz.
- Feature 02 / 08
30 sekund w jednym przebiegu
Ustaw dowolny czas od 2 do 30 sekund, a cały klip wyrenderuje się w jednym generowaniu — ciągłe ruchy kamery i język jednego ujęcia są możliwe bez sklejania osobnych klipów.
- Feature 03 / 08
Natywnie zsynchronizowany dźwięk
Dźwięk powstaje razem z obrazem, a nie jest doklejany później: obejmuje barwę głosu w dialogach, odgłosy otoczenia i rytm muzyczny, więc mowa i akcja pasują do siebie bez dodatkowego przebiegu.
- Feature 04 / 08
Obraz od 480p do 1080p
Wybierz 480p na szybkie szkice, 720p do codziennych publikacji albo 1080p do finalnej pracy. Rozliczenie jest za sekundę na każdym poziomie, więc krótkie testy pozostają tanie, a pełną cenę płacisz tylko za finały.
- Feature 05 / 08
Referencje każdego rodzaju
Tryb referencji na wideo przyjmuje w jednym przebiegu do 10 obrazów referencyjnych, 5 klipów wideo i 5 ścieżek audio, dzięki czemu utrzymasz tę samą postać, produkt lub lokalizację w całej sekwencji.
- Feature 06 / 08
Kontrola pierwszej i ostatniej klatki
Tryb obraz na wideo animuje przesłany obraz pierwszej klatki i opcjonalnie przyjmuje obraz ostatniej klatki, więc dokładnie wskażesz, gdzie ujęcie się zaczyna i na czym ma się skończyć.
- Feature 07 / 08
Tryb pogłębionego myślenia
Włącz tryb myślenia, a model dokładniej przeanalizuje złożony prompt, zanim zacznie generować — to pomaga przy scenach z kilkoma wątkami i nietypowych instrukcjach inscenizacyjnych.
- Feature 08 / 08
Pięć proporcji obrazu
Wybierz 16:9, 9:16, 1:1, 4:3 lub 3:4, aby jednym parametrem obsłużyć format panoramiczny, pionowy mobilny, kwadratowy do social mediów i klasyczne kadrowanie. Tryb obraz na wideo może też podążać za obrazem wejściowym.
Jak korzystać z WAN 3.0 Tekst na wideo
Wygeneruj klip o długości do 30 sekund z opisu tekstowego
Napisz swój prompt
Opisz scenę, temat, ruch kamery, oświetlenie i nastrój. Szczegóły pomagają, a przy złożonych pomysłach możesz włączyć tryb myślenia.
Najczęściej zadawane pytania
Najczęstsze pytania o generowanie wideo w WAN 3.0
Masz jeszcze pytania?
Elastyczny cennik AI
Kredyty kupowane w miarę potrzeb albo plany subskrypcyjne. Bez ukrytych opłat, anulujesz w każdej chwili.
Jednorazowo obsługuje płatności kryptowalutami (BTC, USDT, ETH, 350+)
Monthly billing