


daVinci MagiHuman Generatore Testo/Immagine a Video con Sincronizzazione Audio
Crea video con daVinci MagiHuman - un modello fondamentale audio-video open-source da 15B di Sand.ai e SII GAIR Lab. Genera video e audio sincronizzati da testo o immagini con precisione lip sync leader in 7 lingue. Fino a 1080p, 5-10 secondi. Architettura Transformer single-stream, video 5s 256p in soli 2 secondi su una H100.
/video/text-to-videoGalleria testo-video daVinci MagiHuman
Scopri la potenza cinematografica della generazione testo-video di daVinci MagiHuman. Crea video straordinari con audio sincronizzato a partire da descrizioni testuali dettagliate, con una sincronizzazione labiale all'avanguardia in 7 lingue.
Notte piovosa a Tokyo
Una donna con un cappotto rosso cammina in un vicolo di Tokyo illuminato al neon in una notte piovosa, con riflessi scintillanti.
“Rainy night in a neon-lit Tokyo alley, a woman in a red coat walks slowly under an umbrella. Reflections shimmer on wet cobblestones. Handheld camera follows her from behind, bokeh street lights, cinematic color grade, moody atmosphere.”
Galleria da Immagine a Video di daVinci MagiHuman
Trasforma le tue immagini statiche in video dinamici con daVinci MagiHuman. Scopri una conversione da immagine a video fluida, con espressioni facciali realistiche, movimenti del corpo naturali e audio sincronizzato con il labiale.
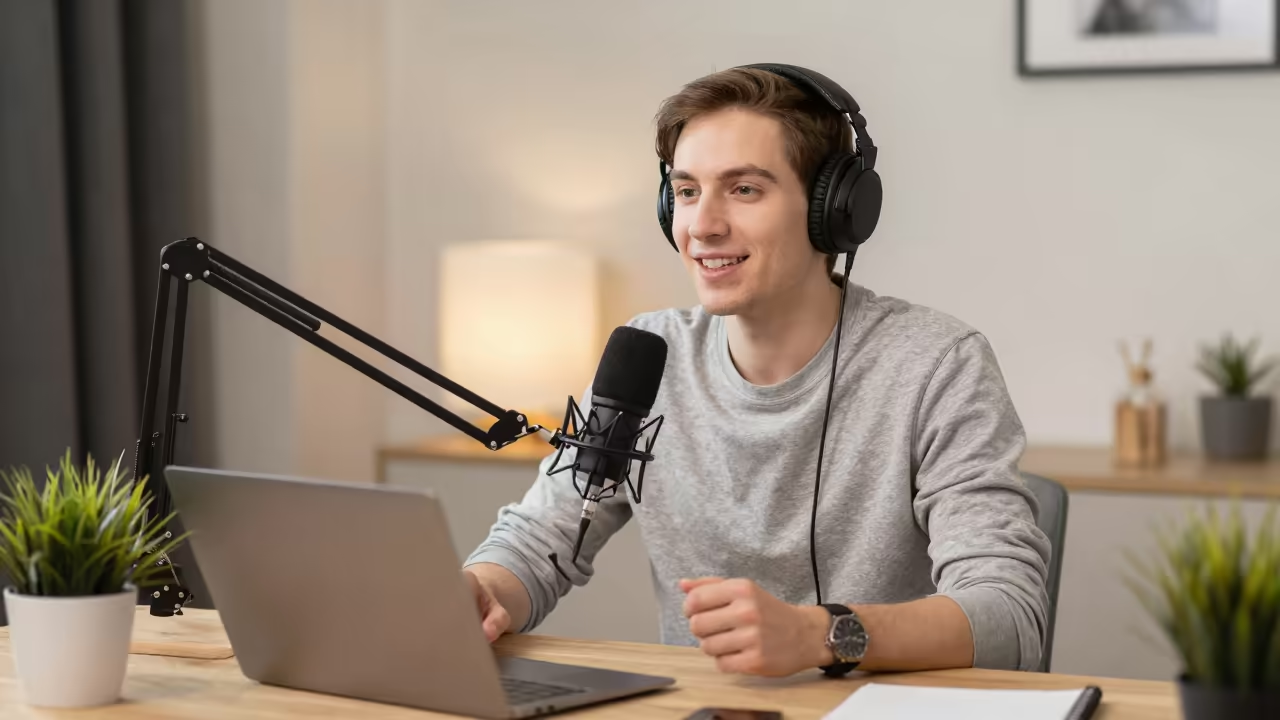
Conduttore di podcast che parla
Video YouTube daVinci MagiHuman
Guarda le dimostrazioni e recensioni della community che mostrano le capacità di generazione audio-video di daVinci MagiHuman
- daVinci-MagiHuman: Fast Audio-Video Synthesis - AI Research Roundup
- 达芬奇最新开源模型,革命Seedance2.0 DaVinci-MagiHuman:开源音视频生成新标杆,5秒视频2秒出,还能说6种语言! - XIAOXIAO LI
- LTX 2.3, Veo и Sora больше не нужны? Тестируем daVinci-MagiHuman - ServerFlow AI Lab - R&D в области ИИ и LLM
- Ai动画224-化繁为简!daVinci-MagiHuman,快速音视频生成基础模型的单流架构,支持多国语言,音画同步,音色参考-T8 Comfyui教程 - T8star-Aix
Video YouTube daVinci MagiHuman
Guarda le dimostrazioni e recensioni della community che mostrano le capacità di generazione audio-video di daVinci MagiHuman
daVinci MagiHuman Recensioni popolari su X
Scopri cosa dicono le persone di daVinci MagiHuman su X (Twitter)
Cos'è daVinci MagiHuman
Il modello fondamentale audio-video open-source da 15B di Sand.ai con il miglior lip sync
- · 0115BParametri
- · 021080pRisoluzione Max
- · 037Lingue Supportate
- · 042sVelocità 256p
daVinci MagiHuman è un Transformer single-stream da 15 miliardi di parametri che genera congiuntamente video e audio sincronizzati da testo o immagini, raggiungendo una precisione di lip sync leader con un tasso di errore parole del 14,6% in 7 lingue.
Funzionalità di daVinci MagiHuman
Scopri le capacità avanzate che rendono daVinci MagiHuman eccezionale per la generazione audio-video
- Feature 01 / 08
Generazione Audio-Video Congiunta
Genera video e audio sincronizzati in un singolo passaggio con architettura Transformer single-stream con solo self-attention, senza pipeline audio separata.
- Feature 02 / 08
Lip Sync Leader del Settore
Tasso di errore parole del 14,6% per la sincronizzazione labiale, superando significativamente Ovi 1.1 (40,45%) e LTX 2.3 (19,23%) nei benchmark di precisione vocale.
- Feature 03 / 08
Supporto Vocale in 7 Lingue
Genera video sincronizzati con il parlato in inglese, cinese (mandarino e cantonese), giapponese, coreano, tedesco e francese con pronuncia naturale.
- Feature 04 / 08
Generazione Ultra-Veloce
Produce un video 256p di 5 secondi in soli 2 secondi su una singola GPU H100. La distillazione DMD-2 in 8 step elimina la necessità di guidance senza classificatore.
- Feature 05 / 08
Doppia Modalità di Input
Crea video da prompt testuali o anima immagini statiche. Entrambe le modalità supportano aspect ratio, risoluzioni e durate da 5 a 10 secondi configurabili.
- Feature 06 / 08
Super-Risoluzione Fino a 1080p
Genera video in 256p, 540p, 720p o 1080p tramite pipeline di super-risoluzione nello spazio latente senza overhead aggiuntivo di decodifica-codifica VAE.
- Feature 07 / 08
Open Source Apache 2.0
Completamente open-source con licenza Apache 2.0 con stack completo inclusi pesi base, modello distillato, modello super-risoluzione e codice di inferenza per uso commerciale illimitato.
- Feature 08 / 08
Eccellenza Centrata sull'Umano
Specializzato nella generazione di umani digitali con espressioni facciali espressive, movimenti corporei realistici e preservazione coerente dei personaggi tra i frame.
Domande Frequenti
Domande comuni sulla generazione audio-video di daVinci MagiHuman
Altre domande?
Come usare daVinci MagiHuman Testo a Video
Genera video con audio sincronizzato da descrizioni testuali
Scrivi il tuo Prompt
Inserisci una descrizione dettagliata del video desiderato. Includi soggetto, azione, contenuto vocale e lingua desiderata per risultati ottimali di lip sync.
Come usare daVinci MagiHuman Immagine a Video
Anima immagini statiche in video con audio sincronizzato
Carica la tua Immagine
Carica un'immagine di riferimento della persona o scena da animare. daVinci MagiHuman eccelle nei contenuti incentrati sull'umano con espressioni facciali realistiche.
Prezzi
Scegli il piano giusto per te. Nessuna tariffa nascosta, nessuna sorpresa.
Una tantum supporta il pagamento in criptovaluta (BTC, USDT, ETH, 350+)
Fatturazione mensile