


🎨 Seedream 5.5 — Il nuovissimo modello di immagini di ByteDance: sfondi trasparenti nativi, fino a 2K ed editing con fino a 10 riferimenti!


Generatore WAN 3.0: testo / immagine / riferimento a video
Genera video con WAN 3.0, il modello video unificato di Alibaba Tongyi Lab, su Dreamega AI. Scrivi un prompt per il testo-a-video, anima un primo fotogramma con un ultimo fotogramma opzionale per l'immagine-a-video, oppure combina fino a 10 immagini, 5 video e 5 tracce audio di riferimento. Ogni modalità produce da 2 a 30 secondi in 480p, 720p o 1080p con audio sincronizzato nativo.
Serie di modelli WAN
WAN 3.0 Prime
Versione più veloce di Wan 3.0, con modifica ed estensione
WAN 2.7
Ultima versione con generazione testo-immagine, editing e video
WAN 2.6
Generazione video migliorata con modalità riferimento e rapida
WAN 2.5
Generazione video alta qualità da testo e immagine
WAN 2.2
Generazione video con proporzioni multiple
WAN 2.2 Animate
Animazione e generazione di movimento specializzate
WAN 2.1
Modello base con input testo e immagine
Galleria video WAN 3.0
Sfoglia clip generate con WAN 3.0 a partire da prompt testuali. Ogni esempio nasce in un'unica passata con audio sincronizzato nativo.
Astronauta nella città invasa dalla natura
Un'astronauta attraversa una città riconquistata dalla vegetazione e trova un bambino con un fiore luminoso, generato da testo.
“A lone astronaut walks through the ruins of a once-busy city, surrounded by abandoned cars, overgrown skyscrapers, and trees growing through cracked streets. She discovers a small child standing inside an old convenience store, holding a glowing flower. The astronaut slowly removes her helmet as birds suddenly rise into the sky and sunlight breaks through the clouds. Emotional science-fiction film, grand post-apocalyptic environment, slow cinematic camera movement, wide establishing shots, intimate facial close-ups, realistic dust particles, warm sunlight contrasting with cold ruins, epic yet hopeful atmosphere.”
Galleria immagine-a-video WAN 3.0
Guarda come WAN 3.0 dà vita a un'immagine statica. La clip qui sotto parte da un solo primo fotogramma e include audio sincronizzato nativo.
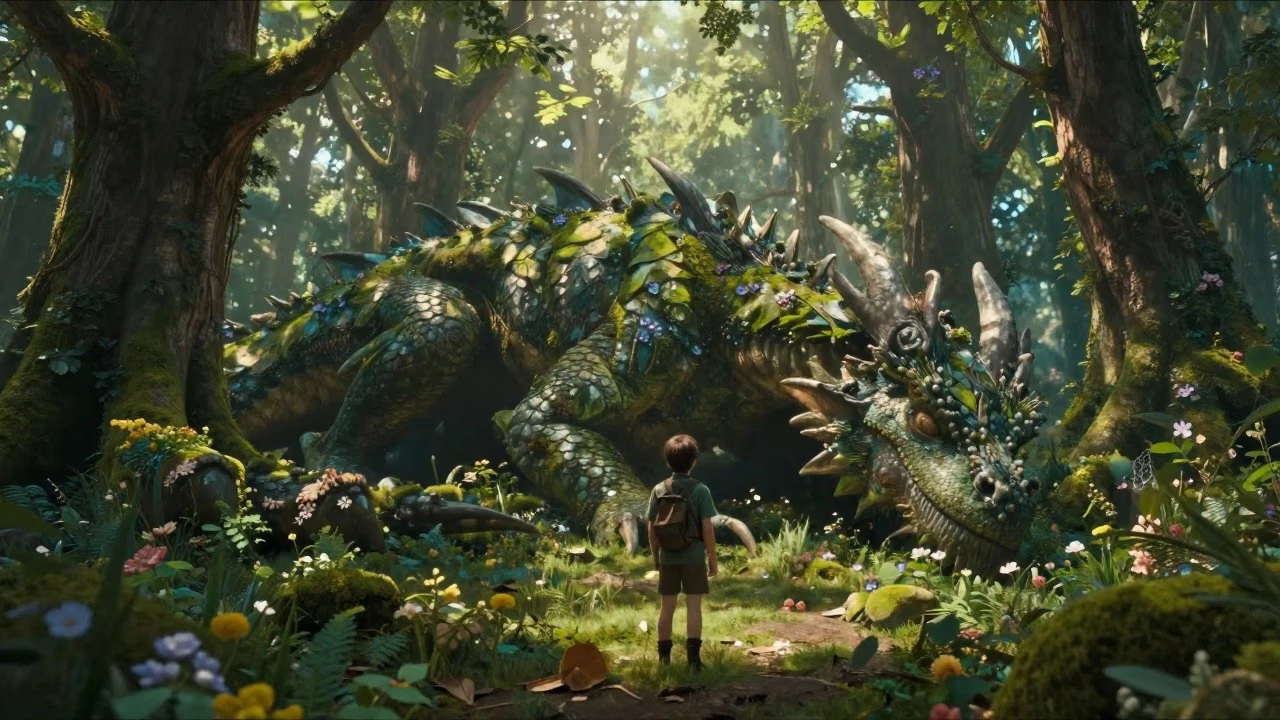
La ranger incontra il drago della foresta
The dragon slowly opens its eyes, leaves move from its breathing, glowing particles float around the forest, the ranger slowly steps forward and reaches out a hand. The camera slowly circles around both characters revealing the enormous scale difference.
Cos'è WAN 3.0
Il modello video unificato di Alibaba Tongyi Lab, disponibile su Dreamega AI
- 2-30sDurata in una passata
- 1080pRisoluzione massima
- 3Modalità: testo / immagine / riferimento
- 10Immagini di riferimento per generazione
WAN 3.0 è il modello di generazione video unificato di Alibaba Tongyi Lab. Mentre WAN 2.7 distribuiva testo-a-video, immagine-a-video, generazione da riferimento ed editing su modelli separati, WAN 3.0 li unisce in uno solo. Su Dreamega AI è disponibile in tre modalità: Testo-a-Video crea una clip da un prompt, Immagine-a-Video anima un primo fotogramma con un ultimo fotogramma opzionale, e Riferimento-a-Video combina fino a 10 immagini, 5 video e 5 tracce audio di riferimento per mantenere coerente il soggetto. Ogni modalità produce da 2 a 30 secondi in una sola passata, in 480p, 720p o 1080p, con audio sincronizzato nativo attivo per impostazione predefinita.
Le funzionalità di WAN 3.0
Cosa offre il modello video unificato di Alibaba per la generazione da testo, immagine e riferimento
- 01
Un unico modello unificato
WAN 2.7 distribuiva testo-a-video, immagine-a-video, generazione da riferimento ed editing su modelli separati. WAN 3.0 li unisce in uno solo, con un comportamento coerente in ogni modalità.
- 02
30 secondi in una passata
Imposta una durata da 2 a 30 secondi: l'intera clip nasce in un'unica generazione, rendendo possibili movimenti di macchina continui e piani sequenza senza montaggio.
- 03
Audio sincronizzato nativo
L'audio nasce insieme all'immagine invece di essere aggiunto dopo: timbro delle voci, suoni ambientali e ritmo musicale si allineano all'azione senza una passata extra.
- 04
Output da 480p a 1080p
480p per le bozze rapide, 720p per la consegna quotidiana, 1080p per il lavoro finale. La fatturazione è al secondo per ogni livello, quindi i test restano economici.
- 05
Input omni-riferimento
Riferimento-a-Video accetta fino a 10 immagini, 5 clip video e 5 tracce audio di riferimento per generazione, per fissare un personaggio, un prodotto o un luogo lungo l'intera sequenza.
- 06
Controllo primo e ultimo fotogramma
Immagine-a-Video anima il primo fotogramma che carichi e accetta opzionalmente un ultimo fotogramma, così decidi con precisione dove inizia e dove finisce l'inquadratura.
- 07
Modalità ragionamento profondo
Attivando la modalità ragionamento il modello elabora più a lungo un prompt complesso prima di generare: utile per scene articolate e messe in scena insolite.
- 08
Cinque rapporti d'aspetto
16:9, 9:16, 1:1, 4:3 o 3:4 coprono widescreen, verticale mobile, feed quadrati e inquadratura classica. Immagine-a-Video può anche seguire l'immagine di input.
Come usare WAN 3.0 Testo a Video
Genera una clip fino a 30 secondi da una descrizione scritta
- 01
Scrivi il prompt
Descrivi scena, soggetto, movimento di macchina, luce e atmosfera. I dettagli aiutano e per le idee complesse puoi attivare la modalità ragionamento.
- 02
Imposta durata, rapporto e risoluzione
Scegli una lunghezza da 2 a 30 secondi, uno dei cinque rapporti d'aspetto e 480p, 720p o 1080p a seconda che sia una bozza o il lavoro finale.
- 03
Genera e scarica
Premi genera: WAN 3.0 produce l'intera clip in una passata con audio sincronizzato. Guarda l'anteprima, poi scarica o rilancia con un prompt modificato.
Video YouTube su WAN 3.0
Guarda demo, recensioni e tutorial della community che mostrano cosa sa fare WAN 3.0
- Wan 3.0 Is Here — 30-Second AI Videos in One Pass - Tech With Hamza
- China Did It AGAIN? – 100+ Wan 3.0 AI Videos - Airt
- WAN 3.0 Is Almost Too Good to Be True.. (Review) - Oprelia AI
- Alibaba Just Dropped Wan 3.0 (And It's FREE To Try) - ByteForward
- How to Access Wan 3.0 Uncensored API - Best Alternative to Seedance 2 - Anil Chandra Naidu Matcha
Video YouTube su WAN 3.0
Guarda demo, recensioni e tutorial della community che mostrano cosa sa fare WAN 3.0
Esplora altri modelli
Altri modelli di IA di punta da provare subito qui.
 NEW
FLUX 3
Modello video multimodale di Black Forest Labs: testo, immagine, primo-ultimo fotogramma ed estensione video con audio nativo, 5-20 secondi fino a 1080p
HappyHorse 1.0
Modello video n°1 di Alibaba, qualità cinematografica d'eccellenza
 NEW
Kling 4.0 Flash
Il modello Kling a 720p di Kuaishou: riprese da 3–20 s con audio nativo, riferimenti e modifica video
 NEW
Veo 3.1
Google Veo 3.1 crea video cinematografici 1080p con audio nativo e sincronizzazione labiale
 NEW
Gemini Omni 1.2 Flash
Il modello video veloce di Google con audio nativo: clip da 3–15 s fino a 4K da testo, immagini, riferimenti o un video esistente
Hailuo 2.3
L'ultimo modello di generazione video ultra-veloce di MiniMax AI con architettura NCR rivoluzionaria e velocità 2,5 volte più veloci
Prezzi
Prezzi
Scegli il piano giusto per te. Nessuna tariffa nascosta, nessuna sorpresa.
Una tantum supporta il pagamento in criptovaluta (BTC, USDT, ETH, 350+) · Fatturazione mensile
Gratuito-Una volta
Prova prima di acquistare
- Fino a 3 video
- Fino a 32 immagini
- Supporto multi-modello
- Testo in video
- Immagine in video
- Video in video
Mostra altro (+11)
- Personaggio coerente
- Generatore di animazioni IA
- Modelli ed effetti
- Miglioramento video IA
- Comunità interattiva
- Generazione più veloce
- Senza filigrana
- Più movimenti fotocamera
- Visibilità video privata
- Protezione dalla copia
- Supporto prioritario
Pro-1 Mese
PopolareMigliora la tua esperienza IA
- Fino a 80 video
- Fino a 800 immagini
- 3 attività(Attività parallele)
- Supporto multi-modello
- Testo in video
- Immagine in video
Mostra altro (+12)
- Video in video
- Personaggio coerente
- Generatore di animazioni IA
- Modelli ed effetti
- Miglioramento video IA
- Comunità interattiva
- Generazione più veloce
- Senza filigrana
- Più movimenti fotocamera
- Visibilità video privata
- Protezione dalla copia
- Supporto prioritario
Lite-1 Mese
Inizia il tuo viaggio IA
- Fino a 30 video
- Fino a 300 immagini
- 3 attività(Attività parallele)
- Supporto multi-modello
- Testo in video
- Immagine in video
Mostra altro (+12)
- Video in video
- Personaggio coerente
- Generatore di animazioni IA
- Modelli ed effetti
- Miglioramento video IA
- Comunità interattiva
- Generazione più veloce
- Senza filigrana
- Più movimenti fotocamera
- Visibilità video privata
- Protezione dalla copia
- Supporto prioritario
- Card
- BTC, USDT, ETH e 350+ criptovalute accettate
Domande frequenti
Domande comuni sulla generazione video con WAN 3.0
Altre domande?