🎨 Seedream 5.5 — 字节跳动最新图像模型:原生透明背景,最高 2K,最多 10 张参考图编辑!


daVinci MagiHuman 文/图生视频生成器 - 支援音频同步
使用 daVinci MagiHuman 创作视频 - Sand.ai 和 SII GAIR Lab 联合开发的 150 亿参数开源音视频基础模型。从文本或图像生成同步的视频和音频,具有业界领先的 7 语种唇语同步精度。支持最高 1080p 分辨率,5-10 秒时长。采用单流 Transformer 架构,无需交叉注意力,在单张 H100 上 2 秒即可生成 5 秒 256p 视频。
daVinci MagiHuman 文生视频画廊
体验 daVinci MagiHuman 文生视频的电影级力量。从详细的文本描述创建带同步音频的精彩视频,具有业界领先的 7 语种唇语同步。
雨夜东京
一位穿红色外套的女性在雨夜的霓虹灯东京小巷中漫步,倒影在湿润的鹅卵石上闪烁。
“Rainy night in a neon-lit Tokyo alley, a woman in a red coat walks slowly under an umbrella. Reflections shimmer on wet cobblestones. Handheld camera follows her from behind, bokeh street lights, cinematic color grade, moody atmosphere.”
daVinci MagiHuman 图生视频画廊
使用 daVinci MagiHuman 将静态图像转换为动态视频。体验无缝的图生视频转换,具有逼真的面部表情、自然的肢体运动和同步的唇语音频。
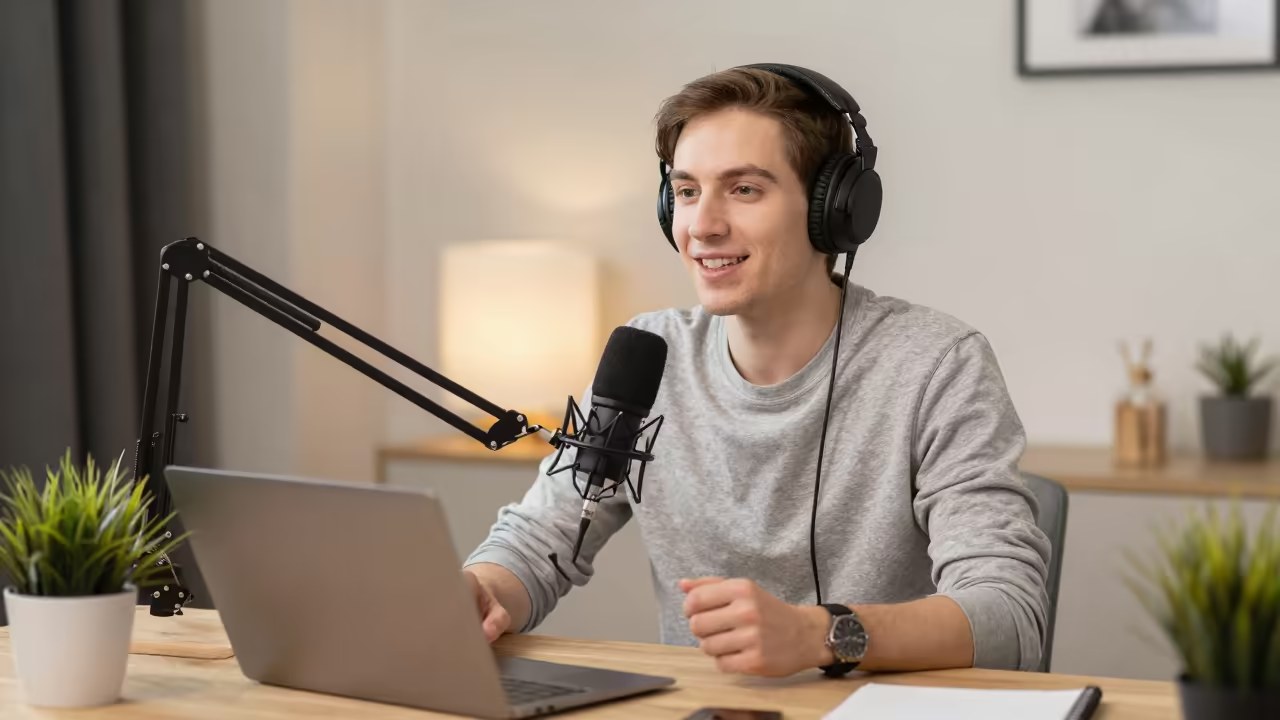
播客主持人说话
什么是 daVinci MagiHuman
Sand.ai 的 150 亿参数开源音视频基础模型,具有业界最佳唇语同步
- 150亿参数量
- 1080p最高分辨率
- 7种支持语言
- 2秒256p生成速度
daVinci MagiHuman 是一个 150 亿参数的单流 Transformer,可从文本或图像联合生成同步的视频和音频,以 14.6% 的词错误率在 7 种语言中实现业界领先的唇语同步精度。
daVinci MagiHuman 强大功能
探索使 daVinci MagiHuman 在音视频生成领域脱颖而出的先进功能
- 01
联合音视频生成
使用统一的单流 Transformer 架构,仅通过自注意力机制在单次推理中生成同步的视频和音频,无需独立的音频管线。
- 02
业界领先的唇语同步
唇语同步的词错误率仅为 14.6%,显著优于 Ovi 1.1(40.45%)和 LTX 2.3(19.23%)等竞品的语音准确率基准。
- 03
7 种语言语音支持
支持生成英语、中文(普通话和粤语)、日语、韩语、德语和法语的语音同步视频,具有自然的发音和唇部动作。
- 04
超快速生成
在单张 H100 GPU 上仅需 2 秒即可生成 5 秒 256p 视频。8 步 DMD-2 蒸馏无需分类器自由引导即可保持质量。
- 05
双输入模式
从文本提示创建视频或将静态图像动画化。文生视频和图生视频模式均支持可配置的宽高比、分辨率和 5-10 秒时长。
- 06
高达 1080p 超分辨率
通过潜空间超分辨率管线生成 256p、540p、720p 或 1080p 视频,无需额外的 VAE 编解码开销即可高效输出高分辨率。
- 07
开源 Apache 2.0
完全以 Apache 2.0 许可证开源,包含完整的基础权重、蒸馏模型、超分辨率模型和推理代码,可无限制商业使用。
- 08
以人为中心的卓越表现
专注于数字人生成,具有富有表现力的面部表情、逼真的肢体运动和跨帧一致的角色保持,适合专业的说话头像内容。
如何使用 daVinci MagiHuman 文生视频
从文本描述生成带同步音频的视频
- 01
编写提示词
输入您想创建的视频的详细描述。包含主题、动作、语音内容和所需语言,以获得最佳唇语同步效果。
- 02
配置设置
选择分辨率(256p 至 1080p)、宽高比(16:9 或 9:16)和时长(5-10 秒)。从 7 种支持的语言中选择语音语言。
- 03
生成视频
点击生成,daVinci MagiHuman 将在一次统一的生成过程中创建带同步音频和唇语同步语音的视频。
如何使用 daVinci MagiHuman 图生视频
将静态图像动画化为带同步音频的视频
- 01
上传图像
上传您想要动画化的人物或场景参考图像。daVinci MagiHuman 擅长以人为中心的内容,具有逼真的面部表情和肢体运动。
- 02
添加提示词和设置
描述所需的运动和语音。选择分辨率(256p 至 1080p)、宽高比、时长(5-10 秒)和 7 种支持语言中的语音语言。
- 03
生成动画视频
点击生成,将您的图像转换为具有自然运动、富有表现力的表演和唇语同步音频的动态视频。
daVinci MagiHuman YouTube 视频
观看社区演示和评测,了解 daVinci MagiHuman 的音视频生成能力
- daVinci-MagiHuman: Fast Audio-Video Synthesis - AI Research Roundup
- 达芬奇最新开源模型,革命Seedance2.0 DaVinci-MagiHuman:开源音视频生成新标杆,5秒视频2秒出,还能说6种语言! - XIAOXIAO LI
- LTX 2.3, Veo и Sora больше не нужны? Тестируем daVinci-MagiHuman - ServerFlow AI Lab - R&D в области ИИ и LLM
- Ai动画224-化繁为简!daVinci-MagiHuman,快速音视频生成基础模型的单流架构,支持多国语言,音画同步,音色参考-T8 Comfyui教程 - T8star-Aix
daVinci MagiHuman YouTube 视频
观看社区演示和评测,了解 daVinci MagiHuman 的音视频生成能力
daVinci MagiHuman 在 X 上的热门评价
看看大家在 X (Twitter) 上对 daVinci MagiHuman 的评价
探索其他模型
更多热门 AI 模型,在这里直接就能用。
 NEW
FLUX 3
Black Forest Labs 的多模态视频模型:文生、图生、首尾帧与视频延长,自带原生音频,5-20 秒最高 1080p
HappyHorse 1.0
阿里巴巴第一视频模型,电影级高质量画面
 NEW
Wan 3.0
统一的 WAN 模型:文生、图生与参考生视频,单次最长 30 秒并自带原生音频
 NEW
Kling 4.0 Flash
快手 720p Kling 模型:3–20 秒成片,支持原生音频、参考素材和视频编辑
 NEW
Veo 3.1
谷歌Veo 3.1创建电影级1080p视频,具有原生音频和唇音同步
 NEW
Gemini Omni 1.2 Flash
谷歌原生音频快速视频模型:从文本、图片、参考素材或现有视频生成 3–15 秒、最高 4K 的片段
AI 价格方案
灵活的 AI 定价
按量付费或订阅计划。无隐藏费用,随时取消。
一次性 支持加密货币支付 (BTC, USDT, ETH, 350+) · 月付账单
免费版-一次性
免费试用
- 最多 3 视频
- 最多 32 图片
- 多模型支持
- 文字转视频
- 图片转视频
- 视频转视频
显示更多 (+11)
- 角色一致性
- AI 动画生成器
- 模板与特效
- AI 视频增强
- 互动社区
- 更快生成速度
- 无水印输出
- 更多镜头运动
- 视频隐私控制
- 复制保护
- 优先支持
专业版-1 月
热门提升您的AI体验
- 最多 80 视频
- 最多 800 图片
- 3 任务(并行任务)
- 多模型支持
- 文字转视频
- 图片转视频
显示更多 (+12)
- 视频转视频
- 角色一致性
- AI 动画生成器
- 模板与特效
- AI 视频增强
- 互动社区
- 更快生成速度
- 无水印输出
- 更多镜头运动
- 视频隐私控制
- 复制保护
- 优先支持
轻量版-1 月
开始您的AI之旅
- 最多 30 视频
- 最多 300 图片
- 3 任务(并行任务)
- 多模型支持
- 文字转视频
- 图片转视频
显示更多 (+12)
- 视频转视频
- 角色一致性
- AI 动画生成器
- 模板与特效
- AI 视频增强
- 互动社区
- 更快生成速度
- 无水印输出
- 更多镜头运动
- 视频隐私控制
- 复制保护
- 优先支持
- 银行卡
- BTC, USDT, ETH 及 350+ 种加密货币已接受