🎨 Seedream 5.5 — 字节跳动最新图像模型:原生透明背景,最高 2K,最多 10 张参考图编辑!


WAN 3.0 文生 / 图生 / 参考生视频生成器
在 Dreamega AI 上使用阿里通义实验室的统一视频模型 WAN 3.0 生成视频。写提示词做文生视频,上传首帧(可选尾帧)做图生视频,或混合最多 10 张参考图、5 段参考视频和 5 段参考音频做参考生视频。三种模式均可生成 2 至 30 秒、480p/720p/1080p 视频,自带同步音频。
WAN 3.0 视频作品集
浏览用 WAN 3.0 由提示词生成的片段。每个示例均为单次生成,自带同步音频。
废墟之城的宇航员
一名宇航员穿过被植物重新占领的城市,遇见手持发光花朵的孩子,由文本生成。
“A lone astronaut walks through the ruins of a once-busy city, surrounded by abandoned cars, overgrown skyscrapers, and trees growing through cracked streets. She discovers a small child standing inside an old convenience store, holding a glowing flower. The astronaut slowly removes her helmet as birds suddenly rise into the sky and sunlight breaks through the clouds. Emotional science-fiction film, grand post-apocalyptic environment, slow cinematic camera movement, wide establishing shots, intimate facial close-ups, realistic dust particles, warm sunlight contrasting with cold ruins, epic yet hopeful atmosphere.”
WAN 3.0 图生视频作品集
看看 WAN 3.0 如何让静态图片动起来。下面的片段由一张首帧图片生成,自带同步音频。
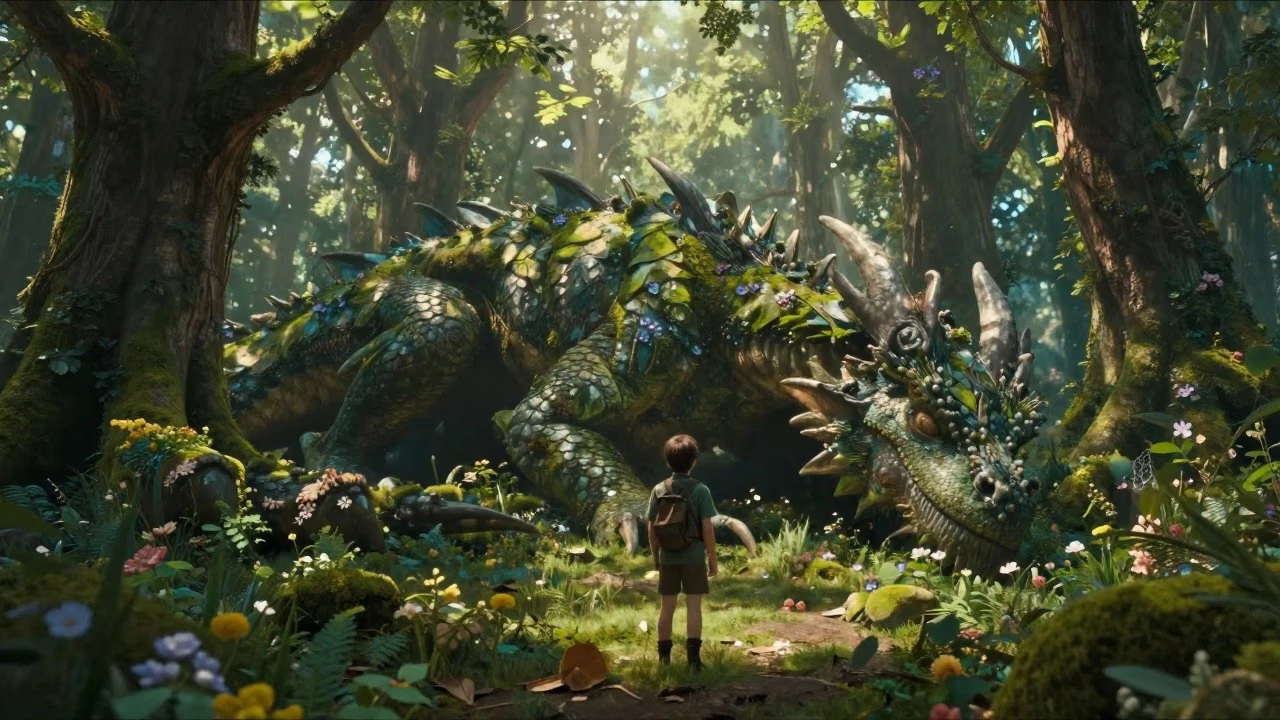
游侠与森林巨龙
The dragon slowly opens its eyes, leaves move from its breathing, glowing particles float around the forest, the ranger slowly steps forward and reaches out a hand. The camera slowly circles around both characters revealing the enormous scale difference.
什么是 WAN 3.0
阿里通义实验室的统一视频模型,已上线 Dreamega AI
- 2-30s单次生成时长
- 1080p最高分辨率
- 3模式:文生 / 图生 / 参考生
- 10单次参考图上限
WAN 3.0 是阿里通义实验室的统一视频生成模型。WAN 2.7 把文生视频、图生视频、参考生成和编辑拆成多个模型,WAN 3.0 则把它们合并为一个。在 Dreamega AI 上提供三种模式:文生视频用提示词直接生成,图生视频让首帧图片动起来并支持可选尾帧,参考生视频可混合最多 10 张参考图、5 段参考视频和 5 段参考音频以保持主体一致。三种模式均单次生成 2 至 30 秒,支持 480p/720p/1080p,默认开启原生同步音频。
WAN 3.0 的核心能力
阿里统一视频模型在文生、图生与参考生成上的表现
- 01
统一为单一模型
WAN 2.7 把文生视频、图生视频、参考生成和编辑拆成多个模型,WAN 3.0 把它们合并为一个,无论从哪种模式开始,表现都保持一致。
- 02
单次生成 30 秒
时长可在 2 至 30 秒之间任选,整段片子一次生成完成,无需拼接即可实现连续运镜和一镜到底的叙事语言。
- 03
原生同步音频
音频与画面同时生成而非事后叠加,覆盖对白音色、环境音与音乐节奏,台词与动作天然对齐,不需要额外流程。
- 04
480p 至 1080p 输出
草稿选 480p,日常交付选 720p,成片选 1080p。各档均按秒计费,试错成本低,只有成片才付全价。
- 05
全模态参考输入
参考生视频单次最多可接收 10 张参考图、5 段参考视频和 5 段音频,让角色、产品或场景在整段序列中保持一致。
- 06
首帧与尾帧控制
图生视频以你上传的首帧图片为起点,并可选加入尾帧图片,从而精确指定镜头从哪里开始、又落到哪一画面。
- 07
深度思考模式
开启思考模式后,模型会在生成前对复杂提示词做更充分的推理,对多段落场景和特殊调度指令更有帮助。
- 08
五种宽高比
可选 16:9、9:16、1:1、4:3 或 3:4,一个参数覆盖宽屏交付、竖屏移动端、方形社交流与经典构图。图生视频还可直接沿用输入图比例。
如何使用 WAN 3.0 文生视频
用一段文字描述生成最长 30 秒的视频
- 01
撰写提示词
描述场景、主体、运镜、光线与氛围。细节越充分效果越好,复杂创意还可开启深度思考模式。
- 02
设置时长、比例与分辨率
在 2 至 30 秒中选择时长,从五种宽高比中挑一个,再根据是草稿还是成片选择 480p、720p 或 1080p。
- 03
生成并下载
点击生成,WAN 3.0 会单次渲染整段视频并附带同步音频。预览结果后即可下载,或调整提示词重新生成。
WAN 3.0 YouTube 视频
观看社区演示、评测与教程,了解 WAN 3.0 的实际表现
- Wan 3.0 Is Here — 30-Second AI Videos in One Pass - Tech With Hamza
- China Did It AGAIN? – 100+ Wan 3.0 AI Videos - Airt
- WAN 3.0 Is Almost Too Good to Be True.. (Review) - Oprelia AI
- Alibaba Just Dropped Wan 3.0 (And It's FREE To Try) - ByteForward
- How to Access Wan 3.0 Uncensored API - Best Alternative to Seedance 2 - Anil Chandra Naidu Matcha
WAN 3.0 YouTube 视频
观看社区演示、评测与教程,了解 WAN 3.0 的实际表现
探索其他模型
更多热门 AI 模型,在这里直接就能用。
 NEW
FLUX 3
Black Forest Labs 的多模态视频模型:文生、图生、首尾帧与视频延长,自带原生音频,5-20 秒最高 1080p
HappyHorse 1.0
阿里巴巴第一视频模型,电影级高质量画面
 NEW
Kling 4.0 Flash
快手 720p Kling 模型:3–20 秒成片,支持原生音频、参考素材和视频编辑
 NEW
Veo 3.1
谷歌Veo 3.1创建电影级1080p视频,具有原生音频和唇音同步
 NEW
Gemini Omni 1.2 Flash
谷歌原生音频快速视频模型:从文本、图片、参考素材或现有视频生成 3–15 秒、最高 4K 的片段
 HOT
Sora 2
OpenAI革命性的视频生成模型,具备同步音频生成和增强物理准确性
AI 价格方案
灵活的 AI 定价
按量付费或订阅计划。无隐藏费用,随时取消。
一次性 支持加密货币支付 (BTC, USDT, ETH, 350+) · 月付账单
免费版-一次性
免费试用
- 最多 3 视频
- 最多 32 图片
- 多模型支持
- 文字转视频
- 图片转视频
- 视频转视频
显示更多 (+11)
- 角色一致性
- AI 动画生成器
- 模板与特效
- AI 视频增强
- 互动社区
- 更快生成速度
- 无水印输出
- 更多镜头运动
- 视频隐私控制
- 复制保护
- 优先支持
专业版-1 月
热门提升您的AI体验
- 最多 80 视频
- 最多 800 图片
- 3 任务(并行任务)
- 多模型支持
- 文字转视频
- 图片转视频
显示更多 (+12)
- 视频转视频
- 角色一致性
- AI 动画生成器
- 模板与特效
- AI 视频增强
- 互动社区
- 更快生成速度
- 无水印输出
- 更多镜头运动
- 视频隐私控制
- 复制保护
- 优先支持
轻量版-1 月
开始您的AI之旅
- 最多 30 视频
- 最多 300 图片
- 3 任务(并行任务)
- 多模型支持
- 文字转视频
- 图片转视频
显示更多 (+12)
- 视频转视频
- 角色一致性
- AI 动画生成器
- 模板与特效
- AI 视频增强
- 互动社区
- 更快生成速度
- 无水印输出
- 更多镜头运动
- 视频隐私控制
- 复制保护
- 优先支持
- 银行卡
- BTC, USDT, ETH 及 350+ 种加密货币已接受