


🎨 Seedream 5.5 — Le tout nouveau modèle d'image de ByteDance : fonds transparents natifs, jusqu'à 2K et édition avec jusqu'à 10 références !


daVinci MagiHuman Générateur Texte/Image vers Vidéo avec Synchronisation Audio
Créez des vidéos avec daVinci MagiHuman - un modèle fondation audio-vidéo open-source de 15B par Sand.ai et SII GAIR Lab. Générez vidéo et audio synchronisés à partir de texte ou d'images avec une précision de lip sync leader dans 7 langues. Jusqu'à 1080p avec 5-10 secondes. Architecture Transformer single-stream, vidéo 5s 256p en seulement 2 secondes sur un H100.
Galerie texte-vers-vidéo daVinci MagiHuman
Découvrez la puissance cinématographique de la génération texte-vers-vidéo de daVinci MagiHuman. Créez des vidéos saisissantes avec un son synchronisé à partir de descriptions textuelles détaillées, avec une synchronisation labiale de pointe dans 7 langues.
Nuit pluvieuse à Tokyo
Une femme en manteau rouge marche dans une ruelle de Tokyo éclairée au néon par une nuit pluvieuse, avec des reflets scintillants.
“Rainy night in a neon-lit Tokyo alley, a woman in a red coat walks slowly under an umbrella. Reflections shimmer on wet cobblestones. Handheld camera follows her from behind, bokeh street lights, cinematic color grade, moody atmosphere.”
Galerie Image vers Vidéo daVinci MagiHuman
Transformez vos images statiques en vidéos dynamiques avec daVinci MagiHuman. Profitez d'une conversion image-vidéo fluide, avec des expressions faciales réalistes, des mouvements corporels naturels et un audio synchronisé avec les lèvres.
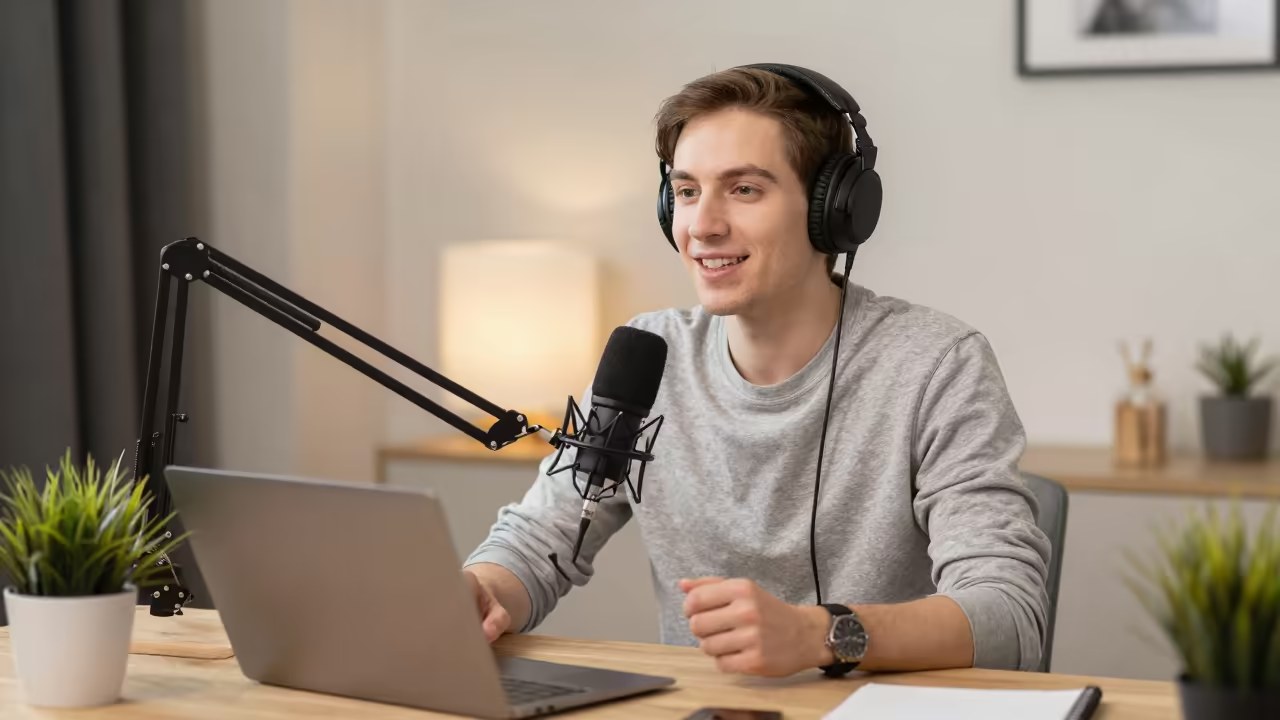
Animateur de podcast en train de parler
Qu'est-ce que daVinci MagiHuman
Le modèle fondation audio-vidéo open-source de 15B de Sand.ai avec le meilleur lip sync
- 15BParamètres
- 1080pRésolution Max
- 7Langues Supportées
- 2sVitesse 256p
daVinci MagiHuman est un Transformer single-stream de 15 milliards de paramètres qui génère conjointement vidéo et audio synchronisés à partir de texte ou d'images, atteignant une précision de lip sync de premier plan avec un taux d'erreur de mots de 14,6% dans 7 langues.
Fonctionnalités de daVinci MagiHuman
Découvrez les capacités avancées qui font de daVinci MagiHuman un outil exceptionnel pour la génération audio-vidéo
- 01
Génération Audio-Vidéo Conjointe
Générez vidéo et audio synchronisés en une seule passe grâce à une architecture Transformer single-stream avec self-attention uniquement, sans pipeline audio séparé.
- 02
Lip Sync Leader du Secteur
Taux d'erreur de mots de 14,6% pour la synchronisation labiale, surpassant significativement Ovi 1.1 (40,45%) et LTX 2.3 (19,23%) dans les benchmarks de précision vocale.
- 03
Support Vocal en 7 Langues
Générez des vidéos synchronisées avec la parole en anglais, chinois (mandarin et cantonais), japonais, coréen, allemand et français avec prononciation naturelle.
- 04
Génération Ultra-Rapide
Produisez une vidéo 256p de 5 secondes en seulement 2 secondes sur un seul GPU H100. La distillation DMD-2 en 8 étapes élimine le besoin de guidance sans classificateur.
- 05
Double Mode d'Entrée
Créez des vidéos à partir de prompts texte ou animez des images fixes. Les deux modes supportent des ratios d'aspect, résolutions et durées de 5 à 10 secondes configurables.
- 06
Super-Résolution Jusqu'à 1080p
Générez des vidéos en 256p, 540p, 720p ou 1080p via un pipeline de super-résolution en espace latent sans surcharge de décodage-encodage VAE supplémentaire.
- 07
Open Source Apache 2.0
Entièrement open-source sous licence Apache 2.0 avec pile complète incluant poids de base, modèle distillé, modèle de super-résolution et code d'inférence pour usage commercial illimité.
- 08
Excellence Centrée sur l'Humain
Spécialisé dans la génération d'humains numériques avec expressions faciales expressives, mouvements corporels réalistes et préservation cohérente des personnages entre les images.
Comment utiliser daVinci MagiHuman Texte vers Vidéo
Générez des vidéos avec audio synchronisé à partir de descriptions textuelles
- 01
Rédigez votre Prompt
Entrez une description détaillée de la vidéo souhaitée. Incluez le sujet, l'action, le contenu vocal et la langue souhaitée pour un lip sync optimal.
- 02
Configurez les Paramètres
Sélectionnez la résolution (256p à 1080p), le ratio (16:9 ou 9:16) et la durée (5-10 secondes). Choisissez la langue vocale parmi 7 options supportées.
- 03
Générez la Vidéo
Cliquez sur générer et daVinci MagiHuman créera votre vidéo avec audio synchronisé et lip sync en une seule passe de génération unifiée.
Comment utiliser daVinci MagiHuman Image vers Vidéo
Animez des images fixes en vidéos avec audio synchronisé
- 01
Téléchargez votre Image
Téléchargez une image de référence de la personne ou scène à animer. daVinci MagiHuman excelle dans le contenu centré sur l'humain avec des expressions faciales réalistes.
- 02
Ajoutez Prompt et Paramètres
Décrivez le mouvement et la parole souhaités. Sélectionnez résolution (256p à 1080p), ratio, durée (5-10 secondes) et langue vocale parmi 7 options.
- 03
Générez la Vidéo Animée
Cliquez pour transformer votre image en vidéo dynamique avec mouvement naturel, performance expressive et audio lip-synced en une génération unifiée.
Vidéos YouTube daVinci MagiHuman
Regardez les démonstrations et critiques de la communauté présentant les capacités de génération audio-vidéo de daVinci MagiHuman
- daVinci-MagiHuman: Fast Audio-Video Synthesis - AI Research Roundup
- 达芬奇最新开源模型,革命Seedance2.0 DaVinci-MagiHuman:开源音视频生成新标杆,5秒视频2秒出,还能说6种语言! - XIAOXIAO LI
- LTX 2.3, Veo и Sora больше не нужны? Тестируем daVinci-MagiHuman - ServerFlow AI Lab - R&D в области ИИ и LLM
- Ai动画224-化繁为简!daVinci-MagiHuman,快速音视频生成基础模型的单流架构,支持多国语言,音画同步,音色参考-T8 Comfyui教程 - T8star-Aix
Vidéos YouTube daVinci MagiHuman
Regardez les démonstrations et critiques de la communauté présentant les capacités de génération audio-vidéo de daVinci MagiHuman
daVinci MagiHuman Avis populaires sur X
Découvrez ce que les gens disent de daVinci MagiHuman sur X (Twitter)
Découvrir d'autres modèles
D'autres modèles d'IA de pointe à essayer ici même.
 NEW
FLUX 3
Modèle vidéo multimodal de Black Forest Labs : texte, image, première-dernière image et extension vidéo avec audio natif, 5-20 secondes jusqu'en 1080p
HappyHorse 1.0
Modèle vidéo n°1 d'Alibaba, qualité cinématographique exceptionnelle
 NEW
Wan 3.0
Modèle WAN unifié : texte, image et référence vers vidéo, jusqu'à 30 secondes en une passe avec audio natif
 NEW
Kling 4.0 Flash
Le modèle Kling 720p de Kuaishou : plans de 3–20 s avec audio natif, références et édition vidéo
 NEW
Veo 3.1
Google Veo 3.1 crée des vidéos cinématographiques 1080p avec audio natif et synchronisation labiale
 NEW
Gemini Omni 1.2 Flash
Le modèle vidéo rapide de Google avec audio natif : clips de 3 à 15 s jusqu'en 4K, à partir de texte, d'images, de références ou d'une vidéo existante
Tarifs
Tarifs
Choisissez le plan qui vous convient. Pas de frais cachés, pas de surprises.
Une fois prend en charge le paiement crypto (BTC, USDT, ETH, 350+) · Facturation mensuelle
Gratuit-Une fois
Essayez avant d'acheter
- Jusqu'à 3 vidéos
- Jusqu'à 32 images
- Support multi-modèles
- Texte vers vidéo
- Image vers vidéo
- Vidéo vers vidéo
Afficher plus (+11)
- Personnage cohérent
- Générateur d'animations IA
- Modèles et effets
- Améliorateurs vidéo IA
- Communauté interactive
- Vitesse de génération plus rapide
- Sans filigrane
- Plus de mouvements de caméra
- Visibilité vidéo privée
- Protection contre la copie
- Support prioritaire
Pro-1 Mois
PopulaireAméliorez votre expérience IA
- Jusqu'à 80 vidéos
- Jusqu'à 800 images
- 3 tâches(Tâches parallèles)
- Support multi-modèles
- Texte vers vidéo
- Image vers vidéo
Afficher plus (+12)
- Vidéo vers vidéo
- Personnage cohérent
- Générateur d'animations IA
- Modèles et effets
- Améliorateurs vidéo IA
- Communauté interactive
- Vitesse de génération plus rapide
- Sans filigrane
- Plus de mouvements de caméra
- Visibilité vidéo privée
- Protection contre la copie
- Support prioritaire
Lite-1 Mois
Commencez votre parcours IA
- Jusqu'à 30 vidéos
- Jusqu'à 300 images
- 3 tâches(Tâches parallèles)
- Support multi-modèles
- Texte vers vidéo
- Image vers vidéo
Afficher plus (+12)
- Vidéo vers vidéo
- Personnage cohérent
- Générateur d'animations IA
- Modèles et effets
- Améliorateurs vidéo IA
- Communauté interactive
- Vitesse de génération plus rapide
- Sans filigrane
- Plus de mouvements de caméra
- Visibilité vidéo privée
- Protection contre la copie
- Support prioritaire
- Card
- BTC, USDT, ETH et 350+ cryptos acceptées
Questions Fréquemment Posées
Questions courantes sur la génération audio-vidéo de daVinci MagiHuman
D'autres questions ?