🎨 Seedream 5.5 — ByteDance の最新画像モデル:ネイティブ透過背景、最大 2K、最大 10 枚の参照画像で編集!


Seedance 2.0 Video Extend - AIで任意の動画クリップをシームレスに継続
ByteDanceのSeedance 2.0 Video Extendは、同じ被写体、位置、服装、顔、レイアウト、照明、画面上のテキスト、動きを維持しながら、既存の動画クリップを継続します。Seed統合マルチモーダルアーキテクチャによる滑らかで時間的に一貫した継続を実現し、必要に応じてプロンプトで次に起こる内容を指示できます。Standard、Fast、Miniの各ティアで、複数の解像度と長さに対応。
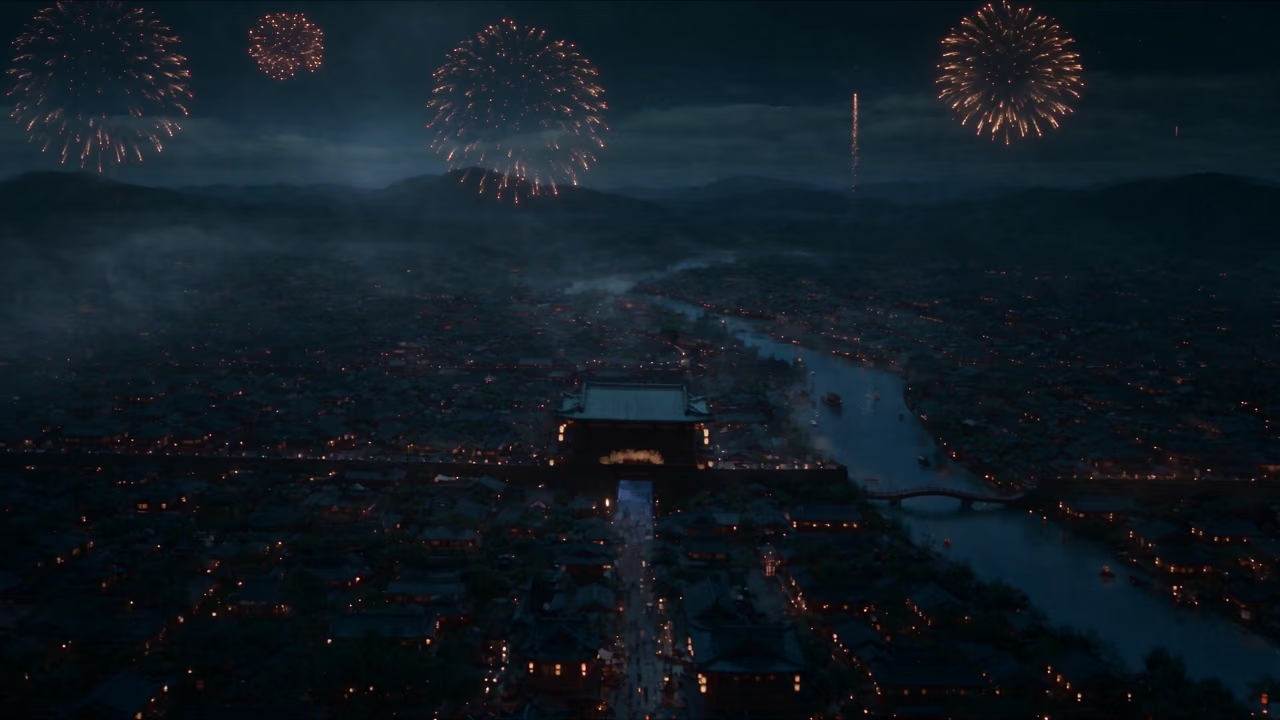
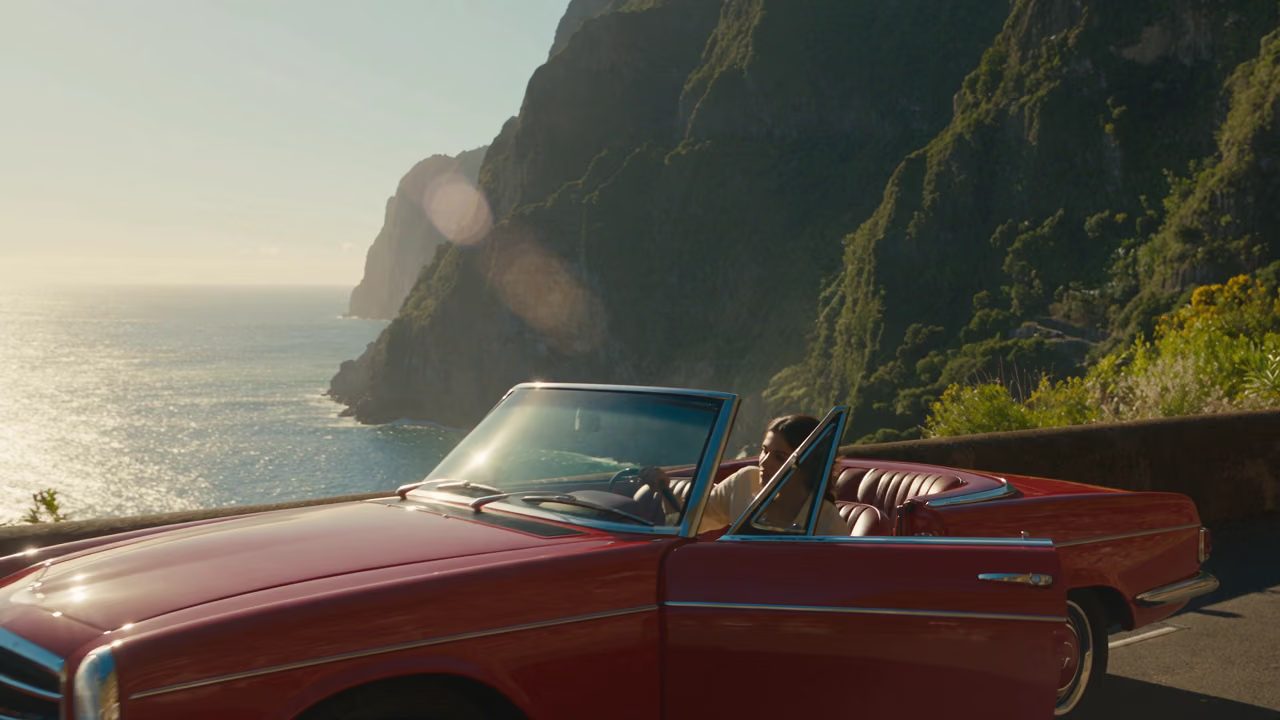
シームレスな動画延長
ソースクリップを前方または後方に延長し、より長く一貫した動画に
地下鉄シーンの継続
Continue the existing subway train scene seamlessly. Keep the same passengers, seating positions, clothing, faces, carriage layout, lighting, handrails, doors, and route display. The route display text "NEXT STOP: CENTRAL STATION" remains stable, readable, and unchanged throughout. The train keeps moving smoothly with a gentle natural sway.
Seedance 2.0 動画延長とは
ByteDance の Dual-Branch Diffusion Transformer で、動画をシームレスに前方または後方へ延長
- シームレス継続
- 3ティア
- 4K解像度
- 30秒最大長
Seedance 2.0 動画延長は、既存の映像を途切れることのない一つのショットで継続し、被写体・照明・動きを保持しながら前方または後方に新しいコンテンツを追加します。3 つのモデルティアで最大 4K 解像度に対応します。
Seedance 2.0 Video Extendの機能
Seedance 2.0 Video Extendが画面上のすべてを一貫させながら、いかにシームレスに映像を継続するかをご紹介
- 01
シームレスな継続
既存のクリップを終わった箇所から正確に継続し、フレーム精度で時間的に一貫した動きを実現、ソースと延長映像の間に目に見える継ぎ目はありません。
- 02
被写体とアイデンティティの保持
ソース動画から延長部分まで同じ人物、顔、服装、オブジェクトを一貫して維持し、キャラクターが最後まで認識できるようにします。
- 03
レイアウトと照明の一貫性
シーン構成、カメラフレーミング、背景レイアウト、照明を維持し、継続部分がひとつの途切れないテイクのように感じられます。
- 04
画面テキストとディテールの保持
画面上のテキスト、ロゴ、細かなディテールを保持し、字幕やグラフィックがドリフトや歪みなく継続部分まで引き継がれます。
- 05
プロンプトによる継続の誘導
画面上にすでにあるすべてをそのまま保ちながら、シンプルなテキストプロンプトで次に起こる内容を任意に指示でき、空白のままにすれば自然な進行になります。
- 06
Standard、Fast、Miniティア
最高の忠実度にはStandard、より速い処理にはFast、ByteDance Seedアーキテクチャに基づく軽量で低コストな延長にはMiniを選択できます。
- 07
柔軟な解像度と長さ
複数の出力解像度と延長時間から選択でき、ソーシャルクリップ、Bロール、長編ストーリーテリングに対応します。
- 08
ループなしのストーリーテリング
Bロールや短いクリップを、ぎこちないループや繰り返し、唐突なカットなしに、より長く自然に進行するシーンへと延長します。
Seedance-2 動画延長の使い方
シームレスな AI 継続で、動画を前方または後方に延長します
- 01
ソースクリップをアップロード
延長したい動画クリップをアップロードします。Seedance 2.0 は被写体、照明、動きを分析し、シーンをシームレスに継続します。
- 02
継続内容を記述(オプション)
シーンを前方または後方にどのように継続するかを記述するプロンプトを任意で入力します。空欄のままにすると AI が自然に延長します。
- 03
延長を生成
シームレスなトランジション、保持されたディテール、最大 4K 解像度の出力を備えた延長動画を生成してダウンロードします。
他のモデルを見る
人気の AI モデルをここでそのまま試せます。
 NEW
FLUX 3
Black Forest Labs のマルチモーダル動画モデル:テキスト・画像・開始/終了フレーム・動画延長、ネイティブ音声付きで5〜20秒、最大1080p
HappyHorse 1.0
Alibaba No.1 動画モデル、シネマティック高品質映像
 NEW
Wan 3.0
統合された WAN モデル:テキスト・画像・参照から動画、ネイティブ音声付きで一度に最長30秒
 NEW
Kling 4.0 Flash
Kuaishou の 720p Kling モデル。3〜20 秒のテイク、ネイティブ音声、リファレンス、動画編集に対応
 NEW
Veo 3.1
Google Veo 3.1はネイティブオーディオとリップシンクを備えたシネマティック1080p動画を作成
 NEW
Gemini Omni 1.2 Flash
音声も生成するGoogleの高速動画モデル。テキスト、画像、リファレンス、既存の動画から、最大4Kで3〜15秒のクリップを作成
料金
料金
あなたに合ったプランを選んでください。隠れた料金や予期せぬ費用はありません。
一回限り は暗号通貨決済に対応 (BTC, USDT, ETH, 350+) · 月間請求
無料-一回限り
購入前にお試し
- 最大 3 動画
- 最大 32 画像
- マルチモデル対応
- テキストから動画
- 画像から動画
- 動画から動画
もっと見る (+11)
- キャラクター一貫性
- AIアニメーション生成
- テンプレートとエフェクト
- AI動画エンハンサー
- インタラクティブコミュニティ
- 高速生成
- 透かしなし出力
- カメラワーク追加
- 動画プライバシー
- コピー保護
- 優先サポート
Pro-1ヶ月
人気AIエクスペリエンスを向上
- 最大 80 動画
- 最大 800 画像
- 3 タスク(並列タスク)
- マルチモデル対応
- テキストから動画
- 画像から動画
もっと見る (+12)
- 動画から動画
- キャラクター一貫性
- AIアニメーション生成
- テンプレートとエフェクト
- AI動画エンハンサー
- インタラクティブコミュニティ
- 高速生成
- 透かしなし出力
- カメラワーク追加
- 動画プライバシー
- コピー保護
- 優先サポート
Lite-1ヶ月
AIの旅を始めよう
- 最大 30 動画
- 最大 300 画像
- 3 タスク(並列タスク)
- マルチモデル対応
- テキストから動画
- 画像から動画
もっと見る (+12)
- 動画から動画
- キャラクター一貫性
- AIアニメーション生成
- テンプレートとエフェクト
- AI動画エンハンサー
- インタラクティブコミュニティ
- 高速生成
- 透かしなし出力
- カメラワーク追加
- 動画プライバシー
- コピー保護
- 優先サポート
- Card
- BTC, USDT, ETH および 350+ 種類の暗号通貨に対応