🎨 Seedream 5.5 — ByteDance の最新画像モデル:ネイティブ透過背景、最大 2K、最大 10 枚の参照画像で編集!


WAN 3.0 テキスト / 画像 / 参照から動画ジェネレーター
Alibaba 通義実験室の統合動画モデル WAN 3.0 を Dreamega AI で使って動画を生成。テキストから動画はプロンプトを書くだけ、画像から動画は最初のフレーム(任意で最後のフレーム)をアップロード、参照から動画は最大10枚の参照画像・5本の参照動画・5本の参照オーディオを組み合わせます。いずれのモードも 480p / 720p / 1080p で2〜30秒、ネイティブ同期オーディオ付き。
WAN 3.0 動画ギャラリー
テキストプロンプトから WAN 3.0 で生成したクリップをご覧ください。すべての例が一度の生成、ネイティブ同期オーディオ付きです。
緑に覆われた廃墟都市の宇宙飛行士
自然に取り戻された都市を歩く宇宙飛行士が、光る花を持つ子どもと出会う。テキストから生成。
“A lone astronaut walks through the ruins of a once-busy city, surrounded by abandoned cars, overgrown skyscrapers, and trees growing through cracked streets. She discovers a small child standing inside an old convenience store, holding a glowing flower. The astronaut slowly removes her helmet as birds suddenly rise into the sky and sunlight breaks through the clouds. Emotional science-fiction film, grand post-apocalyptic environment, slow cinematic camera movement, wide establishing shots, intimate facial close-ups, realistic dust particles, warm sunlight contrasting with cold ruins, epic yet hopeful atmosphere.”
WAN 3.0 画像から動画ギャラリー
WAN 3.0 が静止画をどう動かすかご覧ください。以下のクリップは1枚の開始フレーム画像から生成され、ネイティブ同期オーディオ付きです。
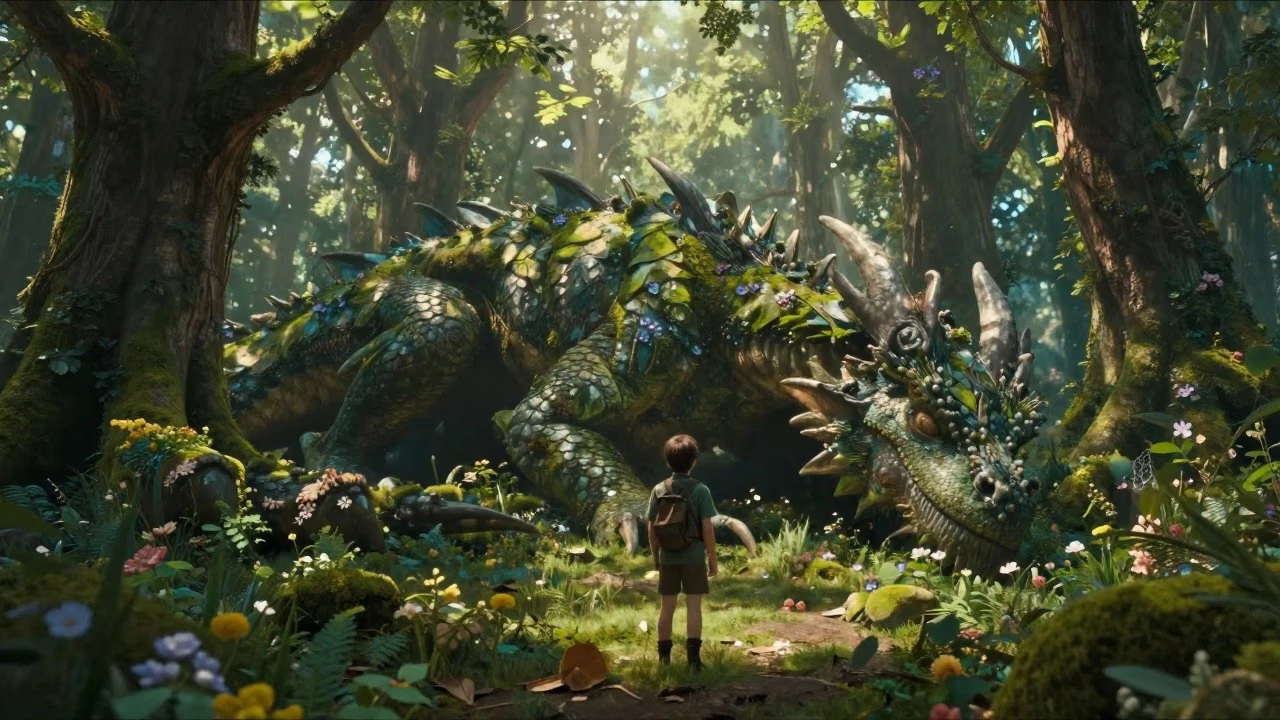
森の竜と出会うレンジャー
The dragon slowly opens its eyes, leaves move from its breathing, glowing particles float around the forest, the ranger slowly steps forward and reaches out a hand. The camera slowly circles around both characters revealing the enormous scale difference.
WAN 3.0 とは
Alibaba 通義実験室の統合動画モデル、Dreamega AI で提供
- 2-30s一度の生成時間
- 1080p最大解像度
- 3モード:テキスト / 画像 / 参照
- 101回あたりの参照画像数
WAN 3.0 は Alibaba 通義実験室の統合動画生成モデルです。WAN 2.7 ではテキストから動画、画像から動画、参照生成、編集がそれぞれ別モデルに分かれていましたが、WAN 3.0 はこれらを1つにまとめています。Dreamega AI では3つのモードを提供します。テキストから動画はプロンプトからクリップを生成し、画像から動画は開始フレーム画像(任意で終了フレーム)をアニメーション化し、参照から動画は最大10枚の参照画像・5本の参照動画・5本の参照オーディオを組み合わせて被写体の一貫性を保ちます。いずれのモードも 480p / 720p / 1080p で2〜30秒を一度に生成し、ネイティブ同期オーディオが既定で有効です。
WAN 3.0 の主な機能
Alibaba の統合動画モデルがテキスト・画像・参照からの生成にもたらすもの
- 01
ひとつに統合されたモデル
WAN 2.7 ではテキストから動画、画像から動画、参照生成、編集が別々のモデルでした。WAN 3.0 はこれらを1つに統合し、どのモードから始めても挙動が一貫します。
- 02
一度の生成で30秒
2〜30秒の任意の長さを指定でき、クリップ全体が一度の生成で仕上がります。連続したカメラワークやワンカットの語り口を、繋ぎ合わせずに実現できます。
- 03
ネイティブ同期オーディオ
音声は後付けではなく映像と同時に生成されます。声色、環境音、音楽のリズムまで含め、セリフと動きが追加工程なしで噛み合います。
- 04
480p〜1080p 出力
下書きは480p、通常納品は720p、仕上げは1080p。各段階とも秒課金なので、試作は安く抑え、仕上げだけに費用をかけられます。
- 05
オムニ参照入力
参照から動画では1回に最大10枚の参照画像、5本の参照動画、5本のオーディオを受け取り、キャラクター・商品・ロケーションをシーン全体で固定できます。
- 06
開始・終了フレーム制御
画像から動画はアップロードした開始フレームを動かし、任意で終了フレーム画像も受け付けます。カットの始点と着地点を正確に指定できます。
- 07
深考モード
思考モードを有効にすると、生成前に複雑なプロンプトをより丁寧に推論します。複数の展開を含むシーンや特殊な演出指示に効果的です。
- 08
5つのアスペクト比
16:9、9:16、1:1、4:3、3:4 から選べ、ワイド納品・縦型モバイル・正方形SNS・クラシックな構図を1つのパラメータでカバー。画像から動画では入力画像に合わせることも可能です。
WAN 3.0 テキストから動画の使い方
文章の説明から最長30秒のクリップを生成します
- 01
プロンプトを書く
シーン、被写体、カメラワーク、ライティング、雰囲気を記述します。詳しく書くほど効果的で、複雑な構想には深考モードを有効にできます。
- 02
長さ・比率・解像度を設定
2〜30秒から長さを選び、5つのアスペクト比から1つを選択し、下書きか仕上げかに応じて 480p / 720p / 1080p を指定します。
- 03
生成してダウンロード
生成をクリックすると、WAN 3.0 が同期オーディオ付きでクリップ全体を一度に描画します。結果を確認してダウンロードするか、プロンプトを調整して再実行します。
WAN 3.0 の YouTube 動画
WAN 3.0 の実力を紹介するコミュニティのデモ・レビュー・チュートリアルをご覧ください
- Wan 3.0 Is Here — 30-Second AI Videos in One Pass - Tech With Hamza
- China Did It AGAIN? – 100+ Wan 3.0 AI Videos - Airt
- WAN 3.0 Is Almost Too Good to Be True.. (Review) - Oprelia AI
- Alibaba Just Dropped Wan 3.0 (And It's FREE To Try) - ByteForward
- How to Access Wan 3.0 Uncensored API - Best Alternative to Seedance 2 - Anil Chandra Naidu Matcha
WAN 3.0 の YouTube 動画
WAN 3.0 の実力を紹介するコミュニティのデモ・レビュー・チュートリアルをご覧ください
他のモデルを見る
人気の AI モデルをここでそのまま試せます。
 NEW
FLUX 3
Black Forest Labs のマルチモーダル動画モデル:テキスト・画像・開始/終了フレーム・動画延長、ネイティブ音声付きで5〜20秒、最大1080p
HappyHorse 1.0
Alibaba No.1 動画モデル、シネマティック高品質映像
 NEW
Kling 4.0 Flash
Kuaishou の 720p Kling モデル。3〜20 秒のテイク、ネイティブ音声、リファレンス、動画編集に対応
 NEW
Veo 3.1
Google Veo 3.1はネイティブオーディオとリップシンクを備えたシネマティック1080p動画を作成
 NEW
Gemini Omni 1.2 Flash
音声も生成するGoogleの高速動画モデル。テキスト、画像、リファレンス、既存の動画から、最大4Kで3〜15秒のクリップを作成
 NEW
Seedance 2.5
バイトダンスの次世代動画モデル。ネイティブ30秒のワンショット生成と、長尺でのショット一貫性の向上を実現
料金
料金
あなたに合ったプランを選んでください。隠れた料金や予期せぬ費用はありません。
一回限り は暗号通貨決済に対応 (BTC, USDT, ETH, 350+) · 月間請求
無料-一回限り
購入前にお試し
- 最大 3 動画
- 最大 32 画像
- マルチモデル対応
- テキストから動画
- 画像から動画
- 動画から動画
もっと見る (+11)
- キャラクター一貫性
- AIアニメーション生成
- テンプレートとエフェクト
- AI動画エンハンサー
- インタラクティブコミュニティ
- 高速生成
- 透かしなし出力
- カメラワーク追加
- 動画プライバシー
- コピー保護
- 優先サポート
Pro-1ヶ月
人気AIエクスペリエンスを向上
- 最大 80 動画
- 最大 800 画像
- 3 タスク(並列タスク)
- マルチモデル対応
- テキストから動画
- 画像から動画
もっと見る (+12)
- 動画から動画
- キャラクター一貫性
- AIアニメーション生成
- テンプレートとエフェクト
- AI動画エンハンサー
- インタラクティブコミュニティ
- 高速生成
- 透かしなし出力
- カメラワーク追加
- 動画プライバシー
- コピー保護
- 優先サポート
Lite-1ヶ月
AIの旅を始めよう
- 最大 30 動画
- 最大 300 画像
- 3 タスク(並列タスク)
- マルチモデル対応
- テキストから動画
- 画像から動画
もっと見る (+12)
- 動画から動画
- キャラクター一貫性
- AIアニメーション生成
- テンプレートとエフェクト
- AI動画エンハンサー
- インタラクティブコミュニティ
- 高速生成
- 透かしなし出力
- カメラワーク追加
- 動画プライバシー
- コピー保護
- 優先サポート
- Card
- BTC, USDT, ETH および 350+ 種類の暗号通貨に対応