


🎨 Seedream 5.5 — O mais novo modelo de imagem da ByteDance: fundos transparentes nativos, até 2K e edição com até 10 referências!


daVinci MagiHuman Gerador de Texto/Imagem para Vídeo com Sincronização de Áudio
Crie vídeos com daVinci MagiHuman - um modelo fundamental de áudio-vídeo open-source de 15B da Sand.ai e SII GAIR Lab. Gere vídeo e áudio sincronizados a partir de texto ou imagens com precisão de lip sync líder em 7 idiomas. Até 1080p, 5-10 segundos. Arquitetura Transformer single-stream, vídeo 5s 256p em apenas 2 segundos em uma H100.
Galeria de texto para vídeo daVinci MagiHuman
Experimente o poder cinematográfico da geração de texto para vídeo do daVinci MagiHuman. Crie vídeos impressionantes com áudio sincronizado a partir de descrições textuais detalhadas, com sincronização labial líder do setor em 7 idiomas.
Noite chuvosa em Tóquio
Uma mulher de casaco vermelho caminha por um beco de Tóquio iluminado por neon em uma noite chuvosa, com reflexos brilhantes.
“Rainy night in a neon-lit Tokyo alley, a woman in a red coat walks slowly under an umbrella. Reflections shimmer on wet cobblestones. Handheld camera follows her from behind, bokeh street lights, cinematic color grade, moody atmosphere.”
Galeria de Imagem para Vídeo daVinci MagiHuman
Transforme suas imagens estáticas em vídeos dinâmicos com o daVinci MagiHuman. Experimente uma conversão perfeita de imagem para vídeo, com expressões faciais realistas, movimento corporal natural e áudio sincronizado com os lábios.
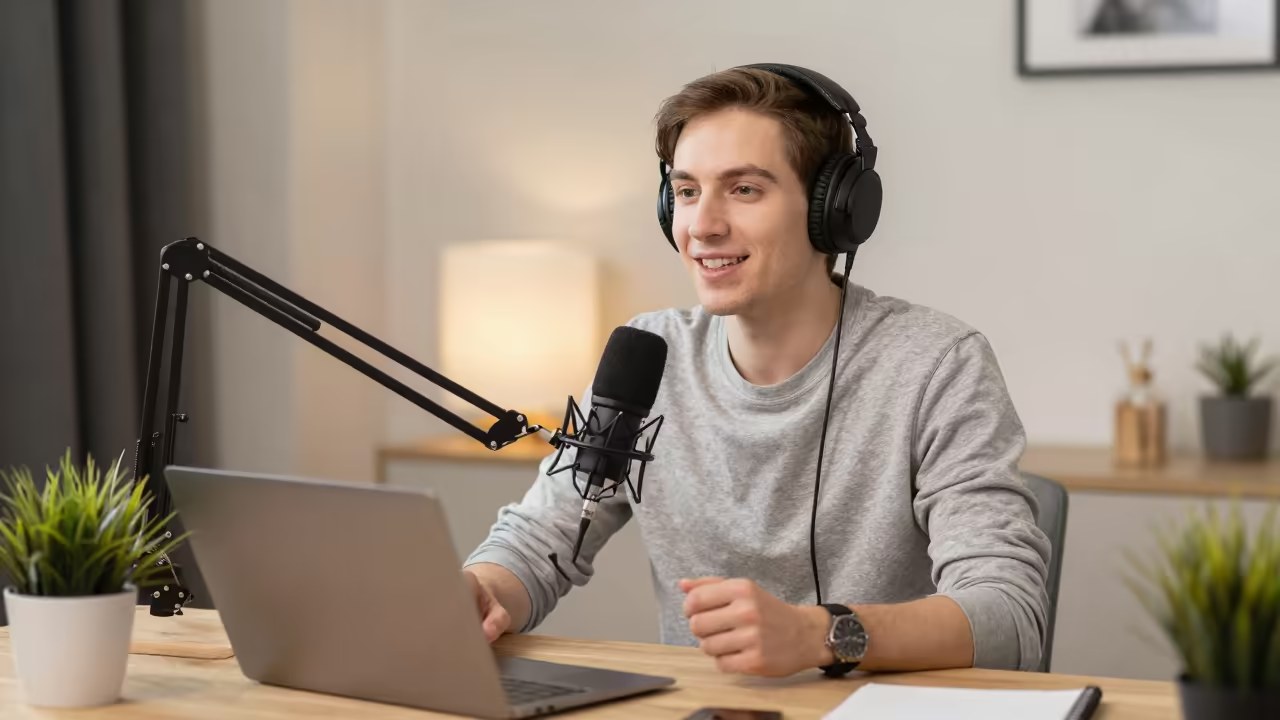
Apresentador de podcast falando
O que é daVinci MagiHuman
O modelo fundamental de áudio-vídeo open-source de 15B da Sand.ai com o melhor lip sync
- 15BParâmetros
- 1080pResolução Máx
- 7Idiomas Suportados
- 2sVelocidade 256p
daVinci MagiHuman é um Transformer single-stream de 15 bilhões de parâmetros que gera conjuntamente vídeo e áudio sincronizados a partir de texto ou imagens, alcançando precisão de lip sync líder com taxa de erro de palavras de 14,6% em 7 idiomas.
Funcionalidades do daVinci MagiHuman
Descubra as capacidades avançadas que tornam o daVinci MagiHuman excepcional para geração de áudio-vídeo
- 01
Geração Conjunta de Áudio-Vídeo
Gere vídeo e áudio sincronizados em uma única passagem usando arquitetura Transformer single-stream com apenas self-attention, sem pipeline de áudio separado.
- 02
Lip Sync Líder do Setor
Taxa de erro de palavras de 14,6% para sincronização labial, superando significativamente Ovi 1.1 (40,45%) e LTX 2.3 (19,23%) em benchmarks de precisão de fala.
- 03
Suporte de Voz em 7 Idiomas
Gere vídeos sincronizados com fala em inglês, chinês (mandarim e cantonês), japonês, coreano, alemão e francês com pronúncia natural.
- 04
Geração Ultra-Rápida
Produza um vídeo 256p de 5 segundos em apenas 2 segundos em uma única GPU H100. Destilação DMD-2 em 8 etapas sem necessidade de guidance sem classificador.
- 05
Modo Duplo de Entrada
Crie vídeos a partir de prompts de texto ou anime imagens estáticas. Ambos os modos suportam proporções, resoluções e durações de 5 a 10 segundos configuráveis.
- 06
Super-Resolução Até 1080p
Gere vídeos em 256p, 540p, 720p ou 1080p via pipeline de super-resolução no espaço latente sem overhead adicional de decodificação-codificação VAE.
- 07
Código Aberto Apache 2.0
Totalmente open-source sob licença Apache 2.0 com stack completo incluindo pesos base, modelo destilado, modelo de super-resolução e código de inferência para uso comercial irrestrito.
- 08
Excelência Centrada no Humano
Especializado em geração de humanos digitais com expressões faciais expressivas, movimentos corporais realistas e preservação consistente de personagens entre frames.
Como usar daVinci MagiHuman Texto para Vídeo
Gere vídeos com áudio sincronizado a partir de descrições de texto
- 01
Escreva seu Prompt
Digite uma descrição detalhada do vídeo desejado. Inclua assunto, ação, conteúdo de fala e idioma desejado para melhores resultados de lip sync.
- 02
Configure as Definições
Selecione resolução (256p a 1080p), proporção (16:9 ou 9:16) e duração (5-10 segundos). Escolha o idioma de fala entre 7 opções suportadas.
- 03
Gere o Vídeo
Clique em gerar e o daVinci MagiHuman criará seu vídeo com áudio sincronizado e lip sync em uma única passagem de geração unificada.
Como usar daVinci MagiHuman Imagem para Vídeo
Anime imagens estáticas em vídeos com áudio sincronizado
- 01
Carregue sua Imagem
Carregue uma imagem de referência da pessoa ou cena a animar. daVinci MagiHuman se destaca em conteúdo centrado no humano com expressões faciais realistas.
- 02
Adicione Prompt e Configurações
Descreva o movimento e fala desejados. Selecione resolução (256p a 1080p), proporção, duração (5-10 segundos) e idioma de fala entre 7 opções.
- 03
Gere Vídeo Animado
Clique para transformar sua imagem em um vídeo dinâmico com movimento natural, performance expressiva e áudio lip-synced em uma geração unificada.
Vídeos do YouTube daVinci MagiHuman
Assista demonstrações e avaliações da comunidade exibindo as capacidades de geração de áudio-vídeo do daVinci MagiHuman
- daVinci-MagiHuman: Fast Audio-Video Synthesis - AI Research Roundup
- 达芬奇最新开源模型,革命Seedance2.0 DaVinci-MagiHuman:开源音视频生成新标杆,5秒视频2秒出,还能说6种语言! - XIAOXIAO LI
- LTX 2.3, Veo и Sora больше не нужны? Тестируем daVinci-MagiHuman - ServerFlow AI Lab - R&D в области ИИ и LLM
- Ai动画224-化繁为简!daVinci-MagiHuman,快速音视频生成基础模型的单流架构,支持多国语言,音画同步,音色参考-T8 Comfyui教程 - T8star-Aix
Vídeos do YouTube daVinci MagiHuman
Assista demonstrações e avaliações da comunidade exibindo as capacidades de geração de áudio-vídeo do daVinci MagiHuman
daVinci MagiHuman Avaliações populares no X
Veja o que as pessoas estão dizendo sobre daVinci MagiHuman no X (Twitter)
Explore outros modelos
Mais modelos de IA de ponta para testar aqui mesmo.
 NEW
FLUX 3
Modelo de vídeo multimodal da Black Forest Labs: texto, imagem, primeiro-último quadro e extensão de vídeo com áudio nativo, 5-20 segundos em até 1080p
HappyHorse 1.0
Modelo de vídeo nº1 da Alibaba, qualidade cinematográfica de alto nível
 NEW
Wan 3.0
Modelo WAN unificado: texto, imagem e referência para vídeo, até 30 segundos em uma passagem com áudio nativo
 NEW
Kling 4.0 Flash
O modelo Kling 720p da Kuaishou: tomadas de 3 a 20 s com áudio nativo, referências e edição de vídeo
 NEW
Veo 3.1
Google Veo 3.1 cria vídeos cinematográficos 1080p com áudio nativo e sincronização labial
 NEW
Gemini Omni 1.2 Flash
O modelo de vídeo rápido do Google com áudio nativo: clipes de 3–15 s até 4K a partir de texto, imagens, referências ou um vídeo existente
Preços
Preços
Escolha o plano certo para você. Sem taxas ocultas, sem surpresas.
Uma vez suporta pagamento com criptomoedas (BTC, USDT, ETH, 350+) · Faturação mensal
Grátis-Uma vez
Experimente antes de comprar
- Até 3 vídeos
- Até 32 imagens
- Suporte multi-modelo
- Texto para vídeo
- Imagem para vídeo
- Vídeo para vídeo
Mostrar mais (+11)
- Personagem consistente
- Gerador de animação IA
- Modelos e efeitos
- Melhoradores de vídeo IA
- Comunidade interativa
- Geração mais rápida
- Sem marca d'água
- Mais movimentos de câmera
- Visibilidade privada de vídeo
- Proteção contra cópia
- Suporte prioritário
Pro-1 Mês
PopularEleve sua experiência com IA
- Até 80 vídeos
- Até 800 imagens
- 3 tarefas(Tarefas paralelas)
- Suporte multi-modelo
- Texto para vídeo
- Imagem para vídeo
Mostrar mais (+12)
- Vídeo para vídeo
- Personagem consistente
- Gerador de animação IA
- Modelos e efeitos
- Melhoradores de vídeo IA
- Comunidade interativa
- Geração mais rápida
- Sem marca d'água
- Mais movimentos de câmera
- Visibilidade privada de vídeo
- Proteção contra cópia
- Suporte prioritário
Lite-1 Mês
Comece sua jornada com IA
- Até 30 vídeos
- Até 300 imagens
- 3 tarefas(Tarefas paralelas)
- Suporte multi-modelo
- Texto para vídeo
- Imagem para vídeo
Mostrar mais (+12)
- Vídeo para vídeo
- Personagem consistente
- Gerador de animação IA
- Modelos e efeitos
- Melhoradores de vídeo IA
- Comunidade interativa
- Geração mais rápida
- Sem marca d'água
- Mais movimentos de câmera
- Visibilidade privada de vídeo
- Proteção contra cópia
- Suporte prioritário
- Card
- BTC, USDT, ETH e 350+ criptomoedas aceitas
Perguntas Frequentes
Perguntas comuns sobre a geração de áudio-vídeo do daVinci MagiHuman
Ainda tem dúvidas?