


🎨 Seedream 5.5 — O mais novo modelo de imagem da ByteDance: fundos transparentes nativos, até 2K e edição com até 10 referências!


Gerador WAN 3.0: texto / imagem / referência para vídeo
Gere vídeos com o WAN 3.0, o modelo de vídeo unificado do Tongyi Lab da Alibaba, na Dreamega AI. Escreva um prompt para texto-para-vídeo, anime um primeiro quadro com um último quadro opcional para imagem-para-vídeo, ou combine até 10 imagens, 5 vídeos e 5 faixas de áudio de referência. Cada modo entrega de 2 a 30 segundos em 480p, 720p ou 1080p com áudio sincronizado nativo.
Série de modelos WAN
WAN 3.0 Prime
Versão mais rápida do Wan 3.0, com edição e extensão
WAN 2.7
Versão mais recente com geração texto-imagem, edição e vídeo
WAN 2.6
Geração de vídeo aprimorada com modos referência e rápido
WAN 2.5
Geração de vídeo alta qualidade a partir de texto e imagem
WAN 2.2
Geração de vídeo com múltiplas proporções
WAN 2.2 Animate
Animação e geração de movimento especializadas
WAN 2.1
Modelo base com entrada de texto e imagem
Galeria de vídeos WAN 3.0
Explore clipes gerados com o WAN 3.0 a partir de prompts de texto. Cada exemplo é criado em uma única passagem com áudio sincronizado nativo.
Astronauta na cidade tomada pela natureza
Uma astronauta atravessa uma cidade retomada pela vegetação e encontra uma criança com uma flor luminosa, gerado a partir de texto.
“A lone astronaut walks through the ruins of a once-busy city, surrounded by abandoned cars, overgrown skyscrapers, and trees growing through cracked streets. She discovers a small child standing inside an old convenience store, holding a glowing flower. The astronaut slowly removes her helmet as birds suddenly rise into the sky and sunlight breaks through the clouds. Emotional science-fiction film, grand post-apocalyptic environment, slow cinematic camera movement, wide establishing shots, intimate facial close-ups, realistic dust particles, warm sunlight contrasting with cold ruins, epic yet hopeful atmosphere.”
Galeria imagem-para-vídeo WAN 3.0
Veja como o WAN 3.0 dá vida a uma imagem estática. O clipe abaixo parte de um único primeiro quadro e traz áudio sincronizado nativo.
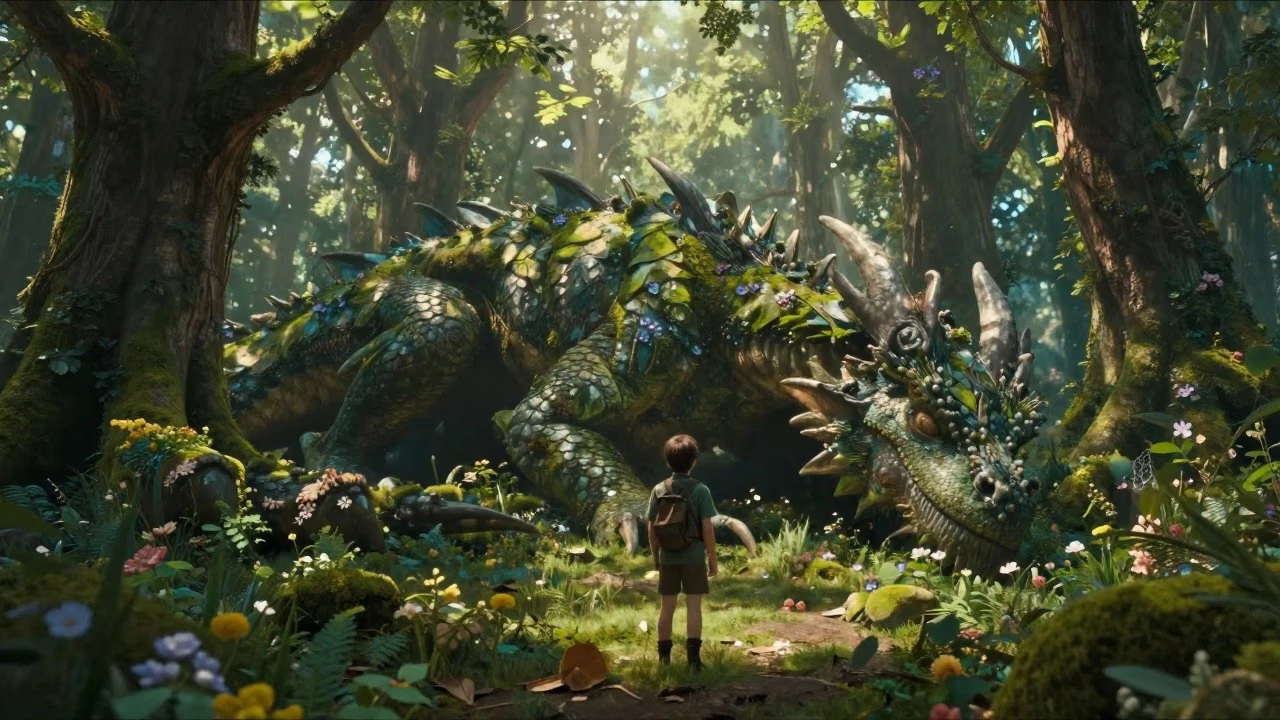
A patrulheira encontra o dragão da floresta
The dragon slowly opens its eyes, leaves move from its breathing, glowing particles float around the forest, the ranger slowly steps forward and reaches out a hand. The camera slowly circles around both characters revealing the enormous scale difference.
O que é o WAN 3.0
O modelo de vídeo unificado do Tongyi Lab da Alibaba, disponível na Dreamega AI
- 2-30sDuração em uma passagem
- 1080pResolução máxima
- 3Modos: texto / imagem / referência
- 10Imagens de referência por geração
O WAN 3.0 é o modelo unificado de geração de vídeo do Tongyi Lab da Alibaba. Enquanto o WAN 2.7 dividia texto-para-vídeo, imagem-para-vídeo, geração por referência e edição em modelos separados, o WAN 3.0 reúne tudo em um só. Na Dreamega AI está disponível em três modos: Texto-para-Vídeo cria um clipe a partir de um prompt, Imagem-para-Vídeo anima um primeiro quadro com um último quadro opcional, e Referência-para-Vídeo combina até 10 imagens, 5 vídeos e 5 faixas de áudio de referência para manter o mesmo sujeito. Cada modo renderiza de 2 a 30 segundos em uma única passagem, em 480p, 720p ou 1080p, com áudio sincronizado nativo ativado por padrão.
Os recursos do WAN 3.0
O que o modelo de vídeo unificado da Alibaba traz para geração por texto, imagem e referência
- 01
Um modelo unificado
O WAN 2.7 dividia texto-para-vídeo, imagem-para-vídeo, geração por referência e edição em modelos separados. O WAN 3.0 reúne tudo em um só, com comportamento consistente em qualquer modo.
- 02
30 segundos em uma passagem
Defina qualquer duração de 2 a 30 segundos: o clipe inteiro é renderizado em uma única geração, tornando possíveis movimentos de câmera contínuos e planos-sequência sem emendas.
- 03
Áudio sincronizado nativo
O áudio é gerado junto com a imagem, não adicionado depois: timbre de voz, som ambiente e ritmo musical se alinham à ação sem uma etapa extra.
- 04
Saída de 480p a 1080p
480p para rascunhos rápidos, 720p para entrega do dia a dia, 1080p para o trabalho final. A cobrança é por segundo em cada nível, então testar sai barato.
- 05
Entradas omni-referência
Referência-para-Vídeo aceita até 10 imagens, 5 clipes de vídeo e 5 faixas de áudio de referência por geração, mantendo personagem, produto ou local iguais em toda a sequência.
- 06
Controle do primeiro e último quadro
Imagem-para-Vídeo anima o primeiro quadro que você envia e aceita opcionalmente um último quadro, definindo exatamente onde a cena começa e onde ela termina.
- 07
Modo de raciocínio profundo
Com o modo de raciocínio ligado, o modelo pensa mais sobre um prompt complexo antes de gerar, o que ajuda em cenas com vários momentos e encenações incomuns.
- 08
Cinco proporções
16:9, 9:16, 1:1, 4:3 ou 3:4 cobrem widescreen, vertical para celular, feeds quadrados e enquadramento clássico. Imagem-para-Vídeo também pode seguir a imagem de entrada.
Como usar o WAN 3.0 Texto para Vídeo
Gere um clipe de até 30 segundos a partir de uma descrição escrita
- 01
Escreva seu prompt
Descreva a cena, o sujeito, o movimento de câmera, a luz e o clima. Detalhes ajudam, e para ideias complexas você pode ligar o modo de raciocínio.
- 02
Defina duração, proporção e resolução
Escolha uma duração de 2 a 30 segundos, uma das cinco proporções e 480p, 720p ou 1080p conforme seja rascunho ou versão final.
- 03
Gere e baixe
Clique em gerar e o WAN 3.0 renderiza o clipe inteiro em uma passagem com áudio sincronizado. Veja a prévia e baixe, ou refaça com o prompt ajustado.
Vídeos do WAN 3.0 no YouTube
Assista a demos, análises e tutoriais da comunidade mostrando o que o WAN 3.0 faz
- Wan 3.0 Is Here — 30-Second AI Videos in One Pass - Tech With Hamza
- China Did It AGAIN? – 100+ Wan 3.0 AI Videos - Airt
- WAN 3.0 Is Almost Too Good to Be True.. (Review) - Oprelia AI
- Alibaba Just Dropped Wan 3.0 (And It's FREE To Try) - ByteForward
- How to Access Wan 3.0 Uncensored API - Best Alternative to Seedance 2 - Anil Chandra Naidu Matcha
Vídeos do WAN 3.0 no YouTube
Assista a demos, análises e tutoriais da comunidade mostrando o que o WAN 3.0 faz
Explore outros modelos
Mais modelos de IA de ponta para testar aqui mesmo.
 NEW
FLUX 3
Modelo de vídeo multimodal da Black Forest Labs: texto, imagem, primeiro-último quadro e extensão de vídeo com áudio nativo, 5-20 segundos em até 1080p
HappyHorse 1.0
Modelo de vídeo nº1 da Alibaba, qualidade cinematográfica de alto nível
 NEW
Kling 4.0 Flash
O modelo Kling 720p da Kuaishou: tomadas de 3 a 20 s com áudio nativo, referências e edição de vídeo
 NEW
Veo 3.1
Google Veo 3.1 cria vídeos cinematográficos 1080p com áudio nativo e sincronização labial
 NEW
Gemini Omni 1.2 Flash
O modelo de vídeo rápido do Google com áudio nativo: clipes de 3–15 s até 4K a partir de texto, imagens, referências ou um vídeo existente
Hailuo 2.3
Mais recente modelo de geração de vídeo ultra-rápido da MiniMax AI com arquitetura NCR revolucionária e velocidades 2,5 vezes mais rápidas
Preços
Preços
Escolha o plano certo para você. Sem taxas ocultas, sem surpresas.
Uma vez suporta pagamento com criptomoedas (BTC, USDT, ETH, 350+) · Faturação mensal
Grátis-Uma vez
Experimente antes de comprar
- Até 3 vídeos
- Até 32 imagens
- Suporte multi-modelo
- Texto para vídeo
- Imagem para vídeo
- Vídeo para vídeo
Mostrar mais (+11)
- Personagem consistente
- Gerador de animação IA
- Modelos e efeitos
- Melhoradores de vídeo IA
- Comunidade interativa
- Geração mais rápida
- Sem marca d'água
- Mais movimentos de câmera
- Visibilidade privada de vídeo
- Proteção contra cópia
- Suporte prioritário
Pro-1 Mês
PopularEleve sua experiência com IA
- Até 80 vídeos
- Até 800 imagens
- 3 tarefas(Tarefas paralelas)
- Suporte multi-modelo
- Texto para vídeo
- Imagem para vídeo
Mostrar mais (+12)
- Vídeo para vídeo
- Personagem consistente
- Gerador de animação IA
- Modelos e efeitos
- Melhoradores de vídeo IA
- Comunidade interativa
- Geração mais rápida
- Sem marca d'água
- Mais movimentos de câmera
- Visibilidade privada de vídeo
- Proteção contra cópia
- Suporte prioritário
Lite-1 Mês
Comece sua jornada com IA
- Até 30 vídeos
- Até 300 imagens
- 3 tarefas(Tarefas paralelas)
- Suporte multi-modelo
- Texto para vídeo
- Imagem para vídeo
Mostrar mais (+12)
- Vídeo para vídeo
- Personagem consistente
- Gerador de animação IA
- Modelos e efeitos
- Melhoradores de vídeo IA
- Comunidade interativa
- Geração mais rápida
- Sem marca d'água
- Mais movimentos de câmera
- Visibilidade privada de vídeo
- Proteção contra cópia
- Suporte prioritário
- Card
- BTC, USDT, ETH e 350+ criptomoedas aceitas
Perguntas frequentes
Dúvidas comuns sobre a geração de vídeo com o WAN 3.0
Ainda tem dúvidas?