





🎨 Seedream 5.0 Pro — ByteDances Flaggschiff-Bildmodell: bis zu 2K, erstklassige Typografie und Multi-Referenz-Bearbeitung!


WAN 3.0 Text- / Bild- / Referenz-zu-Video-Generator
Erzeugen Sie Videos mit WAN 3.0, dem vereinheitlichten Videomodell von Alibabas Tongyi Lab, auf Dreamega AI. Schreiben Sie einen Prompt für Text-zu-Video, animieren Sie ein erstes Bild mit optionalem Endbild für Bild-zu-Video, oder kombinieren Sie bis zu 10 Referenzbilder, 5 Referenzvideos und 5 Audiospuren. Jeder Modus liefert 2 bis 30 Sekunden in 480p, 720p oder 1080p mit nativem synchronisiertem Audio.
WAN Modellserie
WAN 3.0 Prime
Schnellere Wan-3.0-Stufe mit Bearbeiten und Verlängern
WAN 2.7
Neueste Version mit Text-zu-Bild, Bildbearbeitung und Videogenerierung
WAN 2.6
Verbesserte Videogenerierung mit Referenz- und Schnellmodi
WAN 2.5
Hochwertige Text-zu-Video und Bild-zu-Video Generierung
WAN 2.2
Videogenerierung mit mehreren Seitenverhältnissen
WAN 2.2 Animate
Spezialisierte Animation und Bewegungsgenerierung
WAN 2.1
Basis-Videogenerierungsmodell mit Text- und Bildeingabe
WAN 3.0 Videogalerie
Sehen Sie Clips, die mit WAN 3.0 aus Text-Prompts erzeugt wurden. Jedes Beispiel entsteht in einem Durchgang mit nativem synchronisiertem Audio.
Astronautin in der überwucherten Stadt
Eine Astronautin durchquert eine von der Natur zurückeroberte Stadt und findet ein Kind mit einer leuchtenden Blume – aus Text erzeugt.
“A lone astronaut walks through the ruins of a once-busy city, surrounded by abandoned cars, overgrown skyscrapers, and trees growing through cracked streets. She discovers a small child standing inside an old convenience store, holding a glowing flower. The astronaut slowly removes her helmet as birds suddenly rise into the sky and sunlight breaks through the clouds. Emotional science-fiction film, grand post-apocalyptic environment, slow cinematic camera movement, wide establishing shots, intimate facial close-ups, realistic dust particles, warm sunlight contrasting with cold ruins, epic yet hopeful atmosphere.”
WAN 3.0 Bild-zu-Video-Galerie
Sehen Sie, wie WAN 3.0 ein Standbild zum Leben erweckt. Der Clip unten startet von einem einzigen Startbild und enthält nativen synchronisierten Ton.
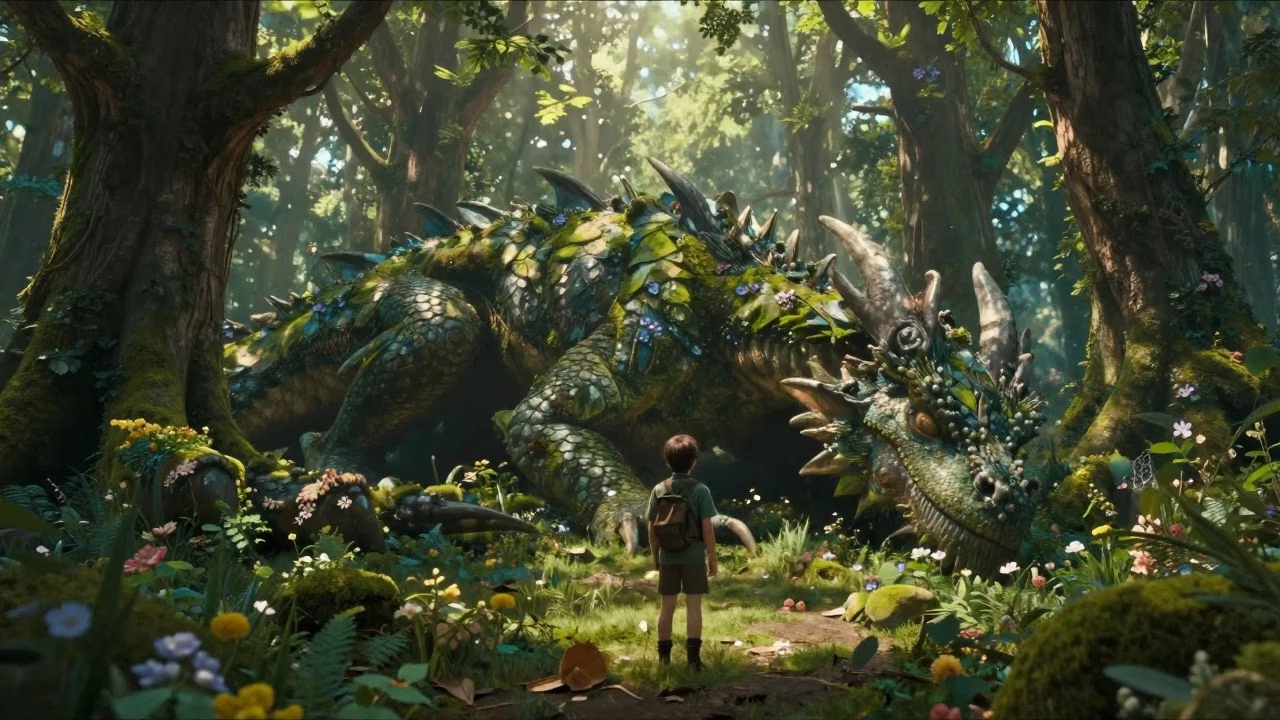
Waldläuferin trifft den Walddrachen
The dragon slowly opens its eyes, leaves move from its breathing, glowing particles float around the forest, the ranger slowly steps forward and reaches out a hand. The camera slowly circles around both characters revealing the enormous scale difference.
Was ist WAN 3.0
Alibabas vereinheitlichtes Videomodell von Tongyi Lab, verfügbar auf Dreamega AI
- 2-30sDauer in einem Durchgang
- 1080pMax. Auflösung
- 3Modi: Text / Bild / Referenz
- 10Referenzbilder pro Lauf
WAN 3.0 ist das vereinheitlichte Videogenerierungsmodell von Alibabas Tongyi Lab. Während WAN 2.7 Text-zu-Video, Bild-zu-Video, Referenzgenerierung und Bearbeitung auf getrennte Modelle verteilte, fasst WAN 3.0 sie in einem zusammen. Auf Dreamega AI stehen drei Modi bereit: Text-zu-Video erzeugt einen Clip aus einem Prompt, Bild-zu-Video animiert ein Startbild mit optionalem Endbild, und Referenz-zu-Video kombiniert bis zu 10 Referenzbilder, 5 Referenzvideos und 5 Audiospuren, damit ein Motiv konsistent bleibt. Jeder Modus rendert 2 bis 30 Sekunden in einem Durchgang in 480p, 720p oder 1080p, mit standardmäßig aktiviertem nativem synchronisiertem Audio.
Die Stärken von WAN 3.0
Was Alibabas vereinheitlichtes Videomodell für text-, bild- und referenzbasierte Generierung leistet
- 01
Ein vereinheitlichtes Modell
WAN 2.7 verteilte Text-zu-Video, Bild-zu-Video, Referenzgenerierung und Bearbeitung auf getrennte Modelle. WAN 3.0 fasst sie in einem zusammen – gleiches Verhalten, egal in welchem Modus.
- 02
30 Sekunden in einem Durchgang
Wählen Sie eine Dauer von 2 bis 30 Sekunden: Der gesamte Clip entsteht in einer Generierung, was durchgehende Kamerafahrten und Plansequenzen ohne Schnitt ermöglicht.
- 03
Natives synchronisiertes Audio
Der Ton entsteht zusammen mit dem Bild statt nachträglich – Stimmfarbe, Umgebungsgeräusche und musikalischer Rhythmus passen ohne zusätzlichen Durchgang zur Handlung.
- 04
Ausgabe von 480p bis 1080p
480p für schnelle Entwürfe, 720p für den Alltag, 1080p für die finale Fassung. Abgerechnet wird pro Sekunde je Stufe, Tests bleiben also günstig.
- 05
Omni-Referenz-Eingaben
Referenz-zu-Video nimmt bis zu 10 Referenzbilder, 5 Videoclips und 5 Audiospuren pro Lauf an, damit Figur, Produkt oder Ort über eine ganze Sequenz gleich bleiben.
- 06
Kontrolle über Start- und Endbild
Bild-zu-Video animiert das hochgeladene Startbild und akzeptiert optional ein Endbild, sodass Sie Anfang und Ziel einer Einstellung genau festlegen.
- 07
Modus für tiefes Nachdenken
Mit aktiviertem Denkmodus verarbeitet das Modell komplexe Prompts vor der Generierung gründlicher – hilfreich bei mehrteiligen Szenen und ungewöhnlichen Anweisungen.
- 08
Fünf Seitenverhältnisse
16:9, 9:16, 1:1, 4:3 oder 3:4 decken Breitbild, vertikales Mobile, quadratische Feeds und klassische Kadrierung ab. Bild-zu-Video kann auch dem Eingabebild folgen.
So nutzen Sie WAN 3.0 Text-zu-Video
Erzeugen Sie aus einer Beschreibung einen Clip von bis zu 30 Sekunden
- 01
Prompt schreiben
Beschreiben Sie Szene, Motiv, Kamerabewegung, Licht und Stimmung. Details helfen, und für komplexe Ideen können Sie den Denkmodus aktivieren.
- 02
Dauer, Format und Auflösung wählen
Wählen Sie eine Länge von 2 bis 30 Sekunden, eines von fünf Seitenverhältnissen und 480p, 720p oder 1080p – je nachdem, ob es ein Entwurf oder die finale Fassung ist.
- 03
Generieren und herunterladen
Auf Generieren klicken: WAN 3.0 rendert den ganzen Clip in einem Durchgang mit synchronem Ton. Ergebnis ansehen, herunterladen oder mit angepasstem Prompt neu starten.
WAN 3.0 YouTube-Videos
Sehen Sie Community-Demos, Reviews und Tutorials, die zeigen, was WAN 3.0 kann
- Wan 3.0 Is Here — 30-Second AI Videos in One Pass - Tech With Hamza
- China Did It AGAIN? – 100+ Wan 3.0 AI Videos - Airt
- WAN 3.0 Is Almost Too Good to Be True.. (Review) - Oprelia AI
- Alibaba Just Dropped Wan 3.0 (And It's FREE To Try) - ByteForward
- How to Access Wan 3.0 API - Best Alternative to Seedance 2 - Anil Chandra Naidu Matcha
WAN 3.0 YouTube-Videos
Sehen Sie Community-Demos, Reviews und Tutorials, die zeigen, was WAN 3.0 kann
Preise
Preise
Wählen Sie den Plan, der zu Ihnen passt. Keine versteckten Gebühren, keine Überraschungen.
Einmalig unterstützt Krypto-Zahlung (BTC, USDT, ETH, 350+) · Monatliche Abrechnung
Kostenlos-Einmalig
Vor dem Kauf testen
- Bis zu 3 Videos
- Bis zu 32 Bilder
- Multi-Modell-Unterstützung
- Text zu Video
- Bild zu Video
- Video zu Video
Mehr anzeigen (+11)
- Konsistenter Charakter
- KI-Animationsgenerator
- Vorlagen & Effekte
- KI-Videoverbesserung
- Interaktive Community
- Schnellere Generierung
- Ohne Wasserzeichen
- Mehr Kamerabewegung
- Private Videosichtbarkeit
- Kopierschutz
- Prioritäts-Support
Pro-1 Monat
BeliebtVerbessern Sie Ihr KI-Erlebnis
- Bis zu 80 Videos
- Bis zu 800 Bilder
- 3 Aufgaben(Parallele Aufgaben)
- Multi-Modell-Unterstützung
- Text zu Video
- Bild zu Video
Mehr anzeigen (+12)
- Video zu Video
- Konsistenter Charakter
- KI-Animationsgenerator
- Vorlagen & Effekte
- KI-Videoverbesserung
- Interaktive Community
- Schnellere Generierung
- Ohne Wasserzeichen
- Mehr Kamerabewegung
- Private Videosichtbarkeit
- Kopierschutz
- Prioritäts-Support
Lite-1 Monat
Starten Sie Ihre KI-Reise
- Bis zu 30 Videos
- Bis zu 300 Bilder
- 3 Aufgaben(Parallele Aufgaben)
- Multi-Modell-Unterstützung
- Text zu Video
- Bild zu Video
Mehr anzeigen (+12)
- Video zu Video
- Konsistenter Charakter
- KI-Animationsgenerator
- Vorlagen & Effekte
- KI-Videoverbesserung
- Interaktive Community
- Schnellere Generierung
- Ohne Wasserzeichen
- Mehr Kamerabewegung
- Private Videosichtbarkeit
- Kopierschutz
- Prioritäts-Support
- Card
- BTC, USDT, ETH und 350+ Kryptowährungen akzeptiert
Häufige Fragen
Häufige Fragen zur Videogenerierung mit WAN 3.0