分身逐个登场
分身一个接一个出现,视频自带揭晓感:开头只有你一个,结尾是整排的你。
🎨 Seedream 5.0 Pro — 字节跳动旗舰图像模型:最高 2K 分辨率,业界顶级文字排版与多图参考编辑!


上传一张照片,看着一个又一个你依次走出来,直到整排的你站满城市街道,每一个都摆着同样的姿势。竖屏 9:16,带节奏感配乐,可直接发抖音、Reels 和 Shorts。
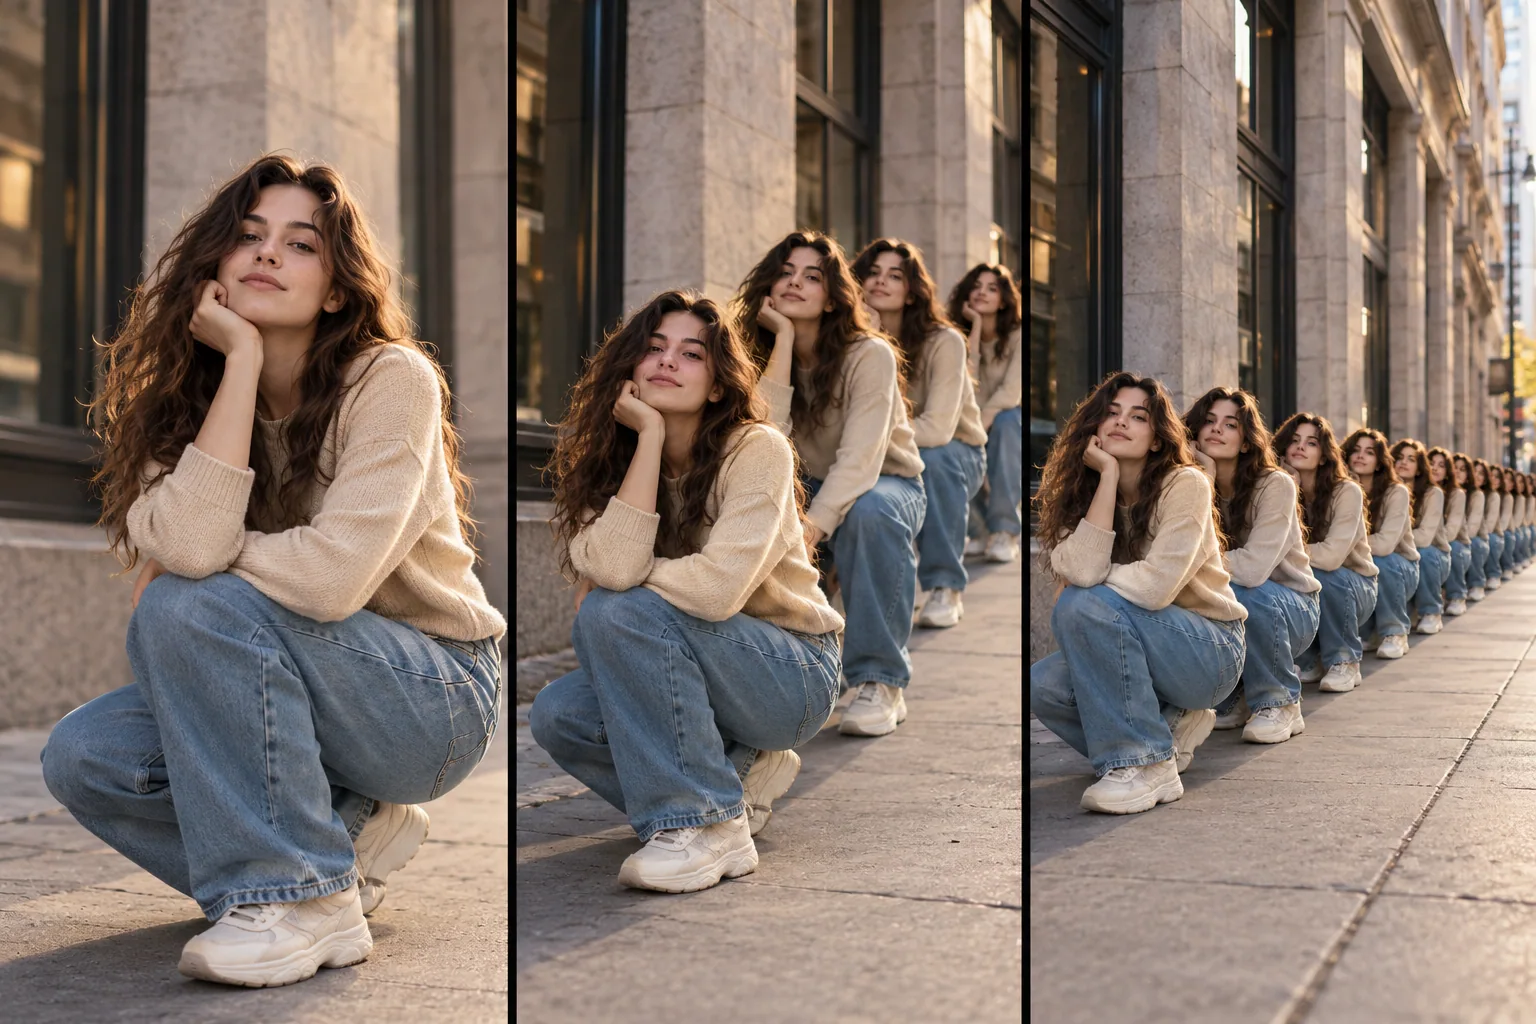
分身一个接一个出现,视频自带揭晓感:开头只有你一个,结尾是整排的你。
你的照片是 Wan 3.0 读取的第一张参考图,每个分身都会保留你的五官、发型和穿着。
Wan 3.0 会同步生成原创音乐和街头环境声,不用再另外加音乐就能发布。
光线好的全身或半身个人照效果最好。只需要一张照片。
选择 5 到 15 秒,以及 480p、720p 或 Pro 专享的 1080p。时长越长,分身登场的时间越充足。
下载一段带声音的竖屏 MP4。默认 720p 5 秒消耗 65 积分,开始前会显示价格。
指南
TL;DR
AI 分身视频让你在画面里成倍出现:一个个分身接连走出来,直到一整队一模一样的你以同一个姿势站满城市街道。一张照片就够,Wan 3.0 会生成带节拍的竖屏 9:16 视频。这是视觉特效,不是会说话的数字人,也不是声音克隆。
AI 分身视频是一段短片:同一个人的分身一个接一个出现,直到一群一模一样的人填满画面。这是一种视觉特效,每个分身都长得像你,而且没有一个会开口说话。
分身镜头是一个老剪辑技巧。手工做的话,要把相机架在三脚架上拍好几条,每次站在不同位置,再在剪辑软件里把这些镜头遮罩拼合。
这个模板用一张照片就能生成整个镜头,包括分身出现的顺序和最后的列队。
不是。搜索“AI 克隆”时会混进好几种不同的东西:照着脚本念稿的数字人、声音克隆,以及照搬爆款视频动作的应用。这个模板都不是。
它不会让你说任何话,不会复制你的声音,也不用参考视频。声音是和视频一起生成的原创音乐和街头环境音。
所以如果你在找会说话的数字人,这里不适合;如果你想要满街都是你,那就对了。
因为分身是一个一个出现的,视频有一个揭晓的过程:从一个人开始,以一群人结束。背景是原创音乐和街头环境音。
手工分身镜头需要一台锁死的相机、好几条素材和细致的遮罩。只要两条之间光线变了,或者三脚架动了一点点,接缝就会露出来。
AI 模板只需要一张照片,逐渐增多的过程也替你做好了。你放弃的是选择权:城市街道、节奏和统一的收尾姿势都是固定的。如果你想让每个分身做不同的事,自己拍仍然更可控。
先用 480p 花 35 积分测试新照片,再用 720p 或 1080p 生成最终版本。
按秒计费:480p 每秒 7 积分,720p 每秒 13 积分,1080p 每秒 28 积分(Pro 会员可用)。默认的 5 秒 720p 视频消耗 65 积分,开始前会显示准确价格。
时长更长,分身在列队前就有更多时间出现,铺垫感更强。生成失败时,积分会自动退回。
| 分辨率 | 时长 | 积分 | 适合 |
|---|---|---|---|
| 480p | 5 秒 | 35 | 先测试照片效果 |
| 720p | 5 秒 | 65 | 大多数发布(默认) |
| 720p | 10 秒 | 130 | 更慢的铺垫 |
| 720p | 15 秒 | 195 | 最长的揭晓 |
| 1080p(Pro) | 5 秒 | 140 | 最清晰的短视频 |
| 1080p(Pro) | 15 秒 | 420 | 最清晰的完整长度 |
熟悉手工分身技巧的观众常会问是怎么做的,AI 标签在大家开口之前就给出了答案。
AI 价格方案
按量付费或订阅计划。无隐藏费用,随时取消。
一次性 支持加密货币支付 (BTC, USDT, ETH, 350+) · 月付账单
免费试用
提升您的AI体验
开始您的AI之旅
我们使用必要存储来运行服务。可选统计、广告和便捷功能只有在您允许后才会启用。 隐私政策